Google DeepMind lanza Gemini 4 Neon: más rápido, económico y potente que Carbon
Google DeepMind presenta Gemini 4 Neon: 110 tokens por segundo, ventana de un millón de tokens y menor coste por tarea frente a Carbon y rivales.
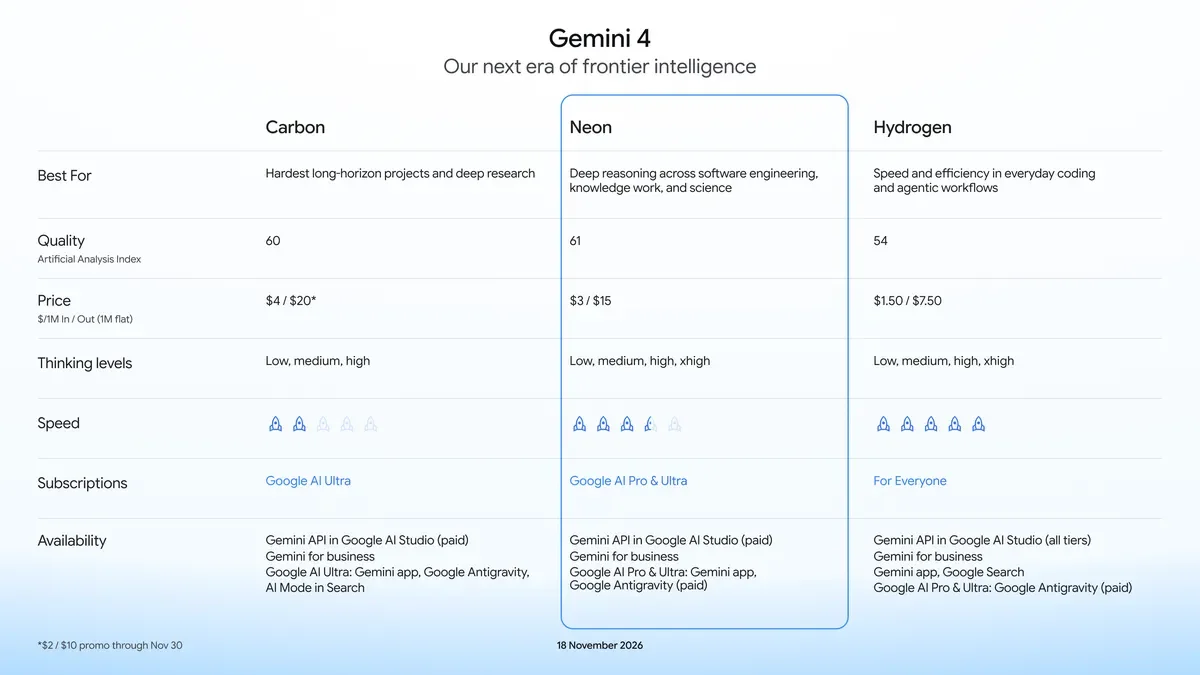
Google DeepMind ha presentado Gemini 4 Neon, su cuarto modelo de inteligencia artificial en apenas siete semanas. Según recoge The Decoder, la nueva versión ofrece una ventana de contexto de un millón de tokens para texto, imágenes, audio y vídeo, y se sitúa dentro del catálogo de la compañía entre Gemini 4 Carbon y Gemini 4 Hydrogen.
Pese a esa posición intermedia, el modelo supera a Carbon en la mayoría de las pruebas de rendimiento a casi el doble de velocidad y con un coste operativo menor. En su nivel de razonamiento más alto, denominado «xhigh», alcanza el tercer puesto general en la clasificación de Artificial Analysis, únicamente por detrás de GPT-6.2 Astra de OpenAI y Claude Fable 5.2 de Anthropic.
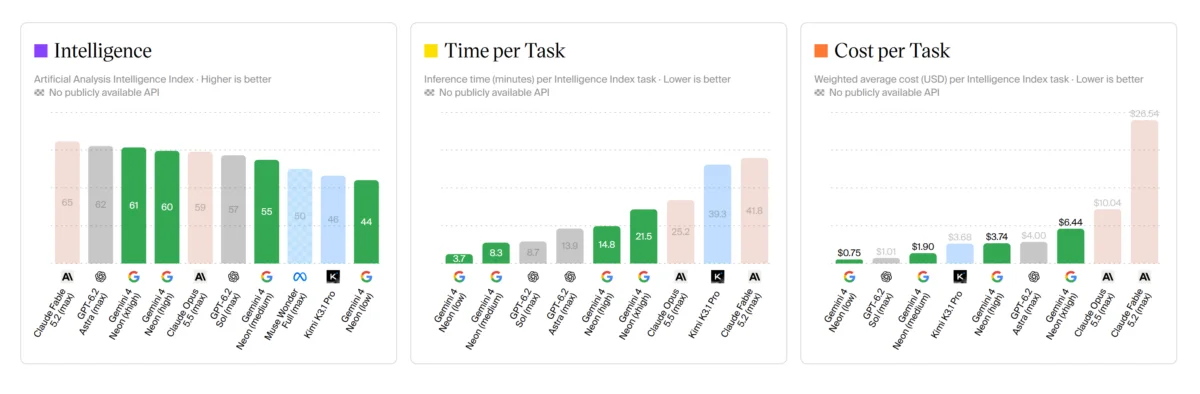
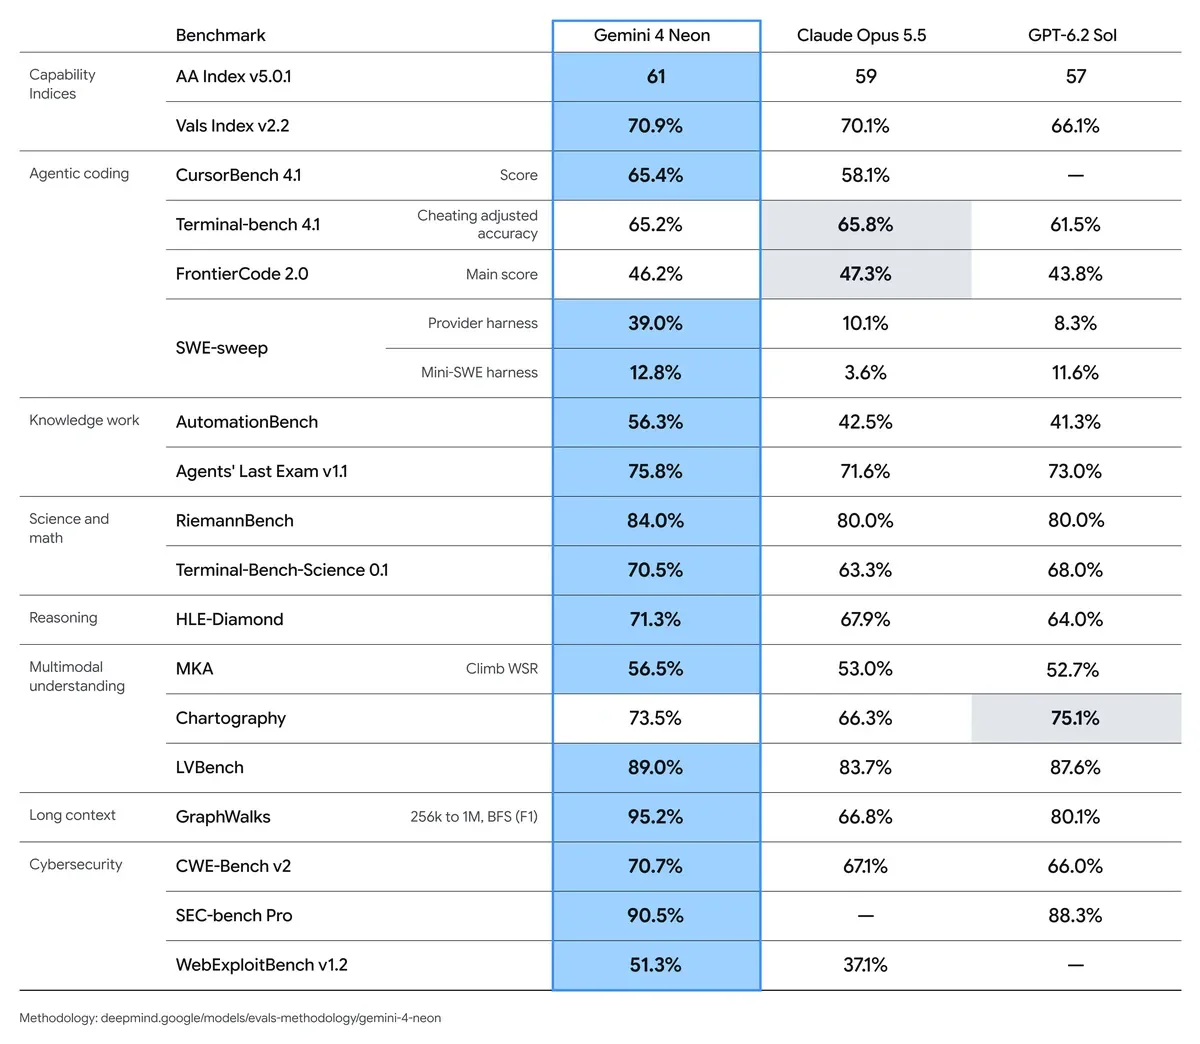
Google DeepMind omitió tanto a GPT-6.2 Astra como a Claude Fable 5.2 en su propia tabla comparativa oficial, donde únicamente contrastó las capacidades de Neon frente a Claude Opus 5.5 y GPT-6.2 Sol.
Precios de lista más bajos frente a un mayor consumo de tokens
El modelo está disponible a través de Google AI Studio y Gemini for Business con tarifas base un 25 % inferiores a las habituales de Carbon, aunque todavía un 50 % por encima del precio promocional que Carbon mantiene vigente hasta finales de noviembre.
De acuerdo con las mediciones de Artificial Analysis, el ahorro por tarea con Gemini 4 Neon no procede de una mayor concisión, ya que consume alrededor de un 15 % más de tokens de salida que Carbon. La reducción del gasto final se explica exclusivamente por el menor precio unitario, mientras que en el nivel «high» iguala la puntuación de inteligencia de su predecesor reduciendo el coste por tarea a la mitad y acortando notablemente los tiempos de ejecución.
| Métrica | Gemini 4 Neon | Gemini 4 Carbon |
|---|---|---|
| Inteligencia (Artificial Analysis, «xhigh») | 61 puntos | 60 puntos |
| Velocidad de generación | ~110 tokens/s | 57 tokens/s |
| Tiempo de ejecución en benchmark | ~21 minutos | ~36 minutos |
| Coste medio por tarea («xhigh») | 6,44 dólares | 7,76 dólares (sin descuento) |
| Entrada / salida (por millón de tokens) | 3 / 15 dólares (0,15 dólares en caché) | 4 / 20 dólares (precio regular) |
Ventaja en agentes de programación y análisis visual
Donde Gemini 4 Neon muestra una ventaja más marcada es en el Coding Agent Index ejecutado dentro del entorno Google Antigravity. En esta prueba supera tanto a Carbon como a los modelos de Anthropic a una fracción del precio habitual. Además, en el ensayo SWE-sweep, el uso del entorno Antigravity triplica la tasa de acierto de Neon hasta alcanzar el 39,0 %.
| Modelo en Google Antigravity | Puntuación (Coding Agent Index) | Coste medio por tarea |
|---|---|---|
| Gemini 4 Neon («xhigh») | 59 puntos | 6,86 dólares |
| Claude Fable 5.2 | 58 puntos | 15,47 dólares |
| Claude Opus 5.5 | 58 puntos | 12,61 dólares |
| Gemini 4 Carbon | 55 puntos | — |
Artificial Analysis también registró avances notables en procesamiento visual. En la prueba documental GDP.pdf, Neon en modo «high» lidera con un 33,4 % —cinco puntos por encima de Carbon—, aunque desciende de forma llamativa al 28,0 % en modo «xhigh». En el test AA-Briefcase sobre calidad de presentaciones, el modelo encabeza la tabla con 1.771 puntos Elo, por delante de Opus 5.5.
Desempeño científico y variante de ciberseguridad
En las evaluaciones propias de Google, Neon lidera categorías individuales en el Vals Index, así como en AutomationBench de Zapier (56,3 %) y pruebas científicas como RiemannBench (84,0 %).
Para especialistas en seguridad informática, la compañía lanza una variante específica a través del programa Fairwind que logra las máximas puntuaciones en SEC-bench Pro (90,5 %) y WebExploitBench v1.2 (51,26 %) a la mitad de precio que sus competidores. Según la ficha técnica oficial (Model Card), el modelo bloquea el 100 % de los ataques de inyección indirecta de instrucciones (indirect prompt-injection) en el benchmark Gray-Swan.
Fuente: The Decoder