Modelos OCR abiertos ya digitalizan un millón de páginas por menos de 130 dólares
Modelos OCR abiertos ya procesan un millón de páginas por menos de 130 dólares tras reducir cinco veces su costo de cómputo en 18 meses.
Modelos OCR abiertos ya digitalizan un millón de páginas por menos de 130 dólares
Extraer texto de libros antiguos y documentos escaneados con inteligencia artificial se ha vuelto cinco veces más económico en apenas 18 meses. Los modelos de reconocimiento óptico de caracteres (OCR) de acceso abierto ahora permiten procesar un millón de páginas por un costo de entre 65 y 130 dólares en alquiler de GPU, según el tipo de material original.
Así lo demuestra una comparativa realizada por Daniel van Strien, investigador de Hugging Face, y recogida por The Decoder. El análisis evaluó ocho modelos gratuitos que reconocen texto en imágenes bajo condiciones idénticas de cómputo para medir la evolución real de su eficiencia económica.
Metodología y caída de costos en 18 meses
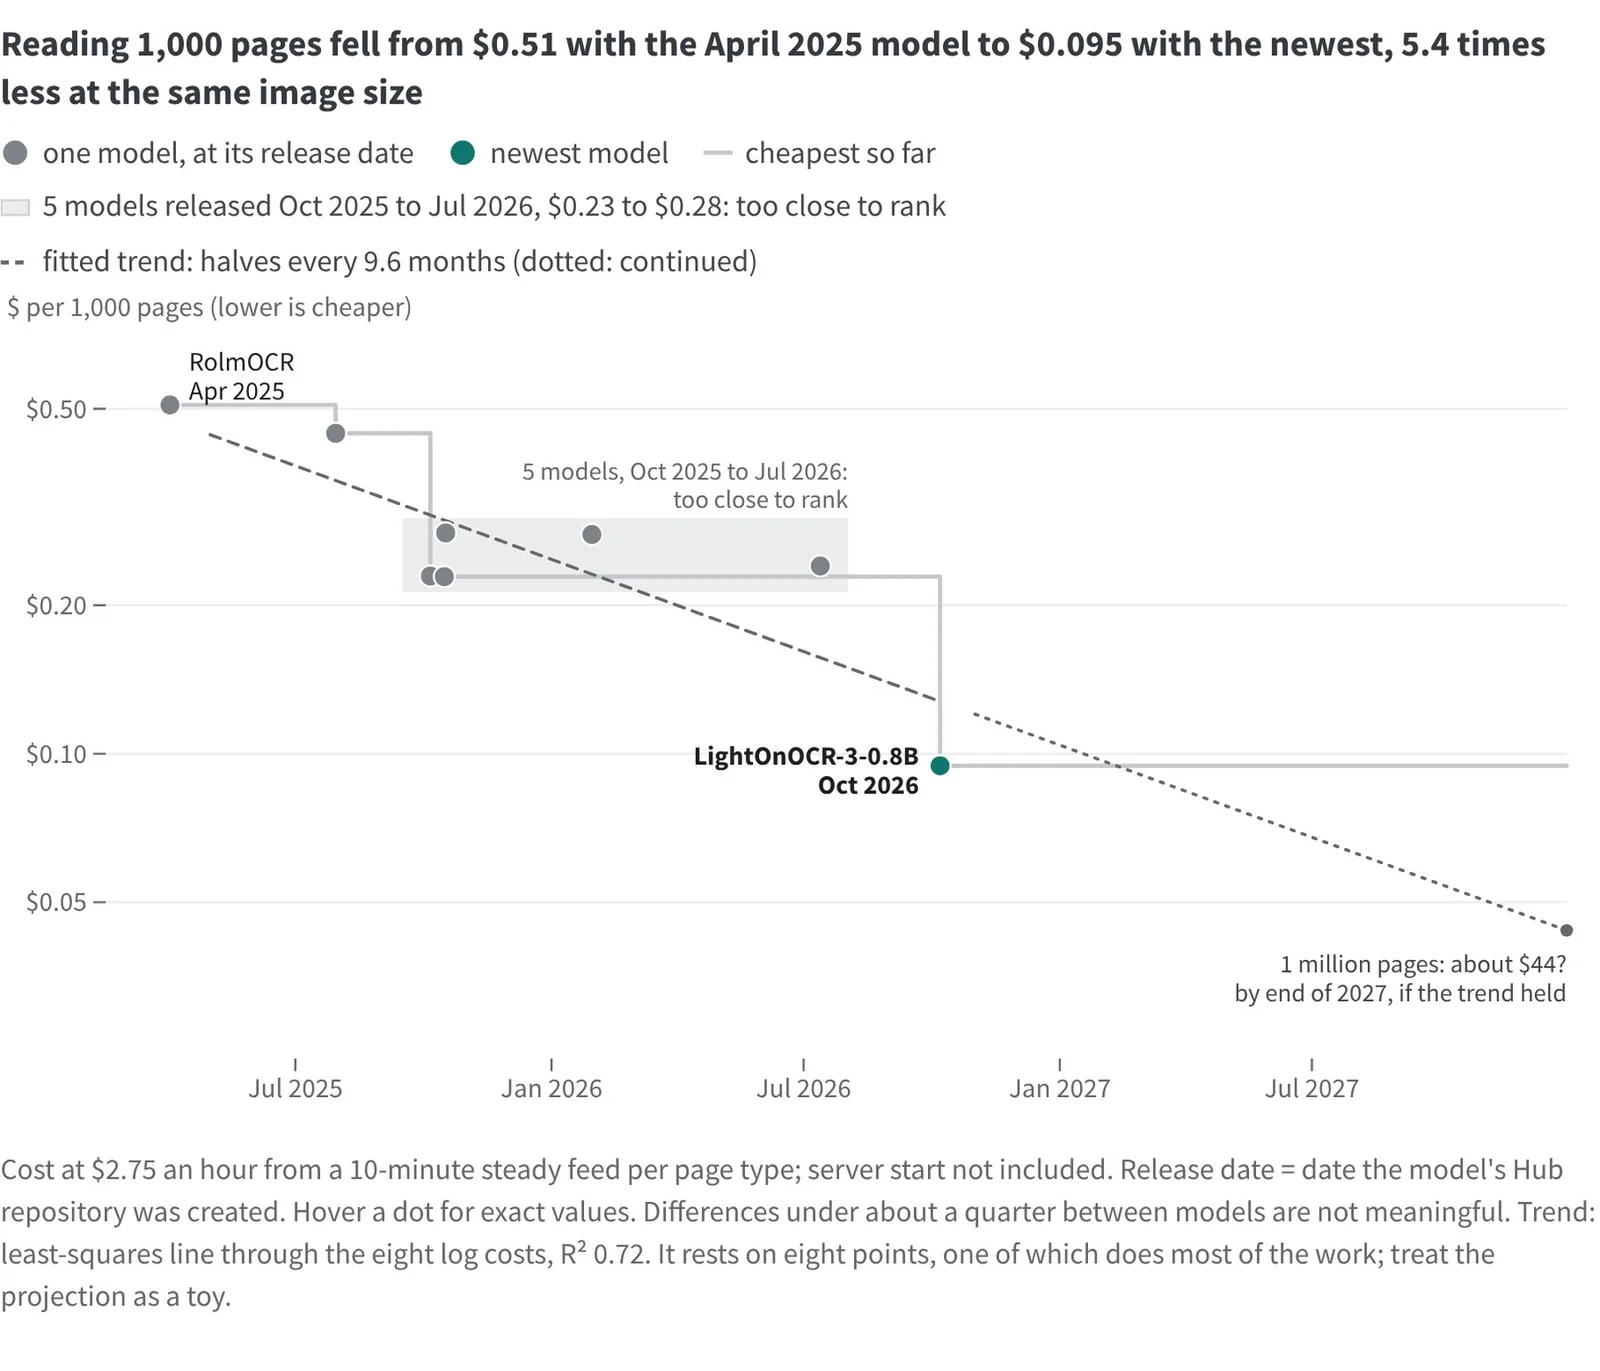
Para garantizar una comparación justa, van Strien probó los ocho sistemas sobre un conjunto de 850 páginas provenientes de antiguos libros de historia natural, la edición de 1771 de la Encyclopaedia Britannica y documentos de archivo mecanografiados e impresos. Todos los modelos se ejecutaron sobre la misma GPU, una Nvidia RTX PRO 6000 alquilada a través de Hugging Face a razón de 2,75 dólares por hora.
| Parámetro / Modelo | Fecha de lanzamiento | Costo por 1.000 páginas | Costo estimado por 1 millón de páginas |
|---|---|---|---|
| RolmOCR | Abril de 2025 | ~0,51 dólares | — |
| Modelos intermedios (5 evaluados) | Entre 2025 y 2026 | Casi a la par entre sí | — |
| LightOnOCR-3-0.8B | Octubre de 2026 | < 0,10 dólares (0,095 USD) | 65 a 130 dólares |
Con el mismo tamaño de imagen, la diferencia entre el sistema más antiguo y el más reciente marca un descenso superior al 80 % en el gasto operativo. Los cinco modelos intermedios analizados en el estudio mostraron un rendimiento económico muy similar entre ellos, situando el mayor salto de eficiencia en la última generación lanzada en octubre de 2026.
La optimización pesa tanto como la arquitectura
Más allá del cambio de modelo, el investigador de Hugging Face subrayó que la forma en que se ejecuta el software resulta determinante para reducir la factura de cómputo. Optimizar la canalización de trabajo generó ahorros equivalentes, o incluso superiores, a los obtenidos al migrar hacia modelos más nuevos.
Entre las medidas aplicadas para lograr esa reducción destacan cuatro ajustes operativos clave:
- Alimentar las páginas de manera más uniforme hacia el modelo para evitar cuellos de botella.
- Utilizar escaneos de menor resolución cuando la legibilidad lo permite.
- Mantener el software de inferencia actualizado.
- Ejecutar las cargas de trabajo sobre una GPU más rápida.
Precisión y límites pendientes
El abaratamiento no implicó una pérdida de calidad en la transcripción de documentos históricos. LightOnOCR-3-0.8B logró leer páginas de libros con al menos la misma precisión que RolmOCR, demostrando que la compresión de costos y la mejora en eficiencia no penalizan la exactitud en textos complejos.
No obstante, el análisis también identificó fallos puntuales en algunos de los sistemas evaluados. Ciertos modelos llegaron a alucinar texto inexistente sobre páginas en blanco o a repetir el mismo contenido en bucle, un recordatorio de que la validación automática sigue siendo necesaria en flujos de digitalización masiva.
Fuente: The Decoder