Hugging Face integra el enrutador de OpenRouter para ejecutar modelos de pesos abiertos a escala
Hugging Face reemplaza su enrutador de modelos por OpenRouter, con reintentos automáticos entre más de 80 proveedores y sin recargos adicionales.
Hugging Face y OpenRouter han unido fuerzas para simplificar la ejecución de modelos de pesos abiertos (open-weight) a gran escala. A partir de este acuerdo, el servicio Inference Providers abandona su enrutador propio para adoptar la infraestructura de OpenRouter, según anunció Hugging Face en su blog oficial.
Con este cambio, las solicitudes dirigidas a modelos de lenguaje se enrutan automáticamente entre más de 80 proveedores según mediciones en tiempo real de precio, velocidad y fiabilidad. Si el primer proveedor falla o sufre saturación, la petición se reintenta en otra alternativa dentro de la misma llamada sin que el desarrollador deba modificar su código.
Compatibilidad con API y herramientas de desarrollo
El nuevo enrutador es compatible con las API de Chat Completions y Responses de OpenAI, así como con la API de Messages de Anthropic para cualquier modelo conversacional. Además, ofrece guías de configuración directa para agentes de programación y entornos como Claude Code, Codex, OpenCode, Pi y Hermes Agent.
El mismo token de Hugging Face mantiene el acceso al resto del ecosistema de la plataforma: almacenamiento mediante Storage Buckets, cómputo con Jobs e inferencia dedicada en Inference Endpoints. Los planes PRO, Team y Enterprise conservan sus créditos mensuales para cómputo e inferencia.
El auge de los modelos de pesos abiertos
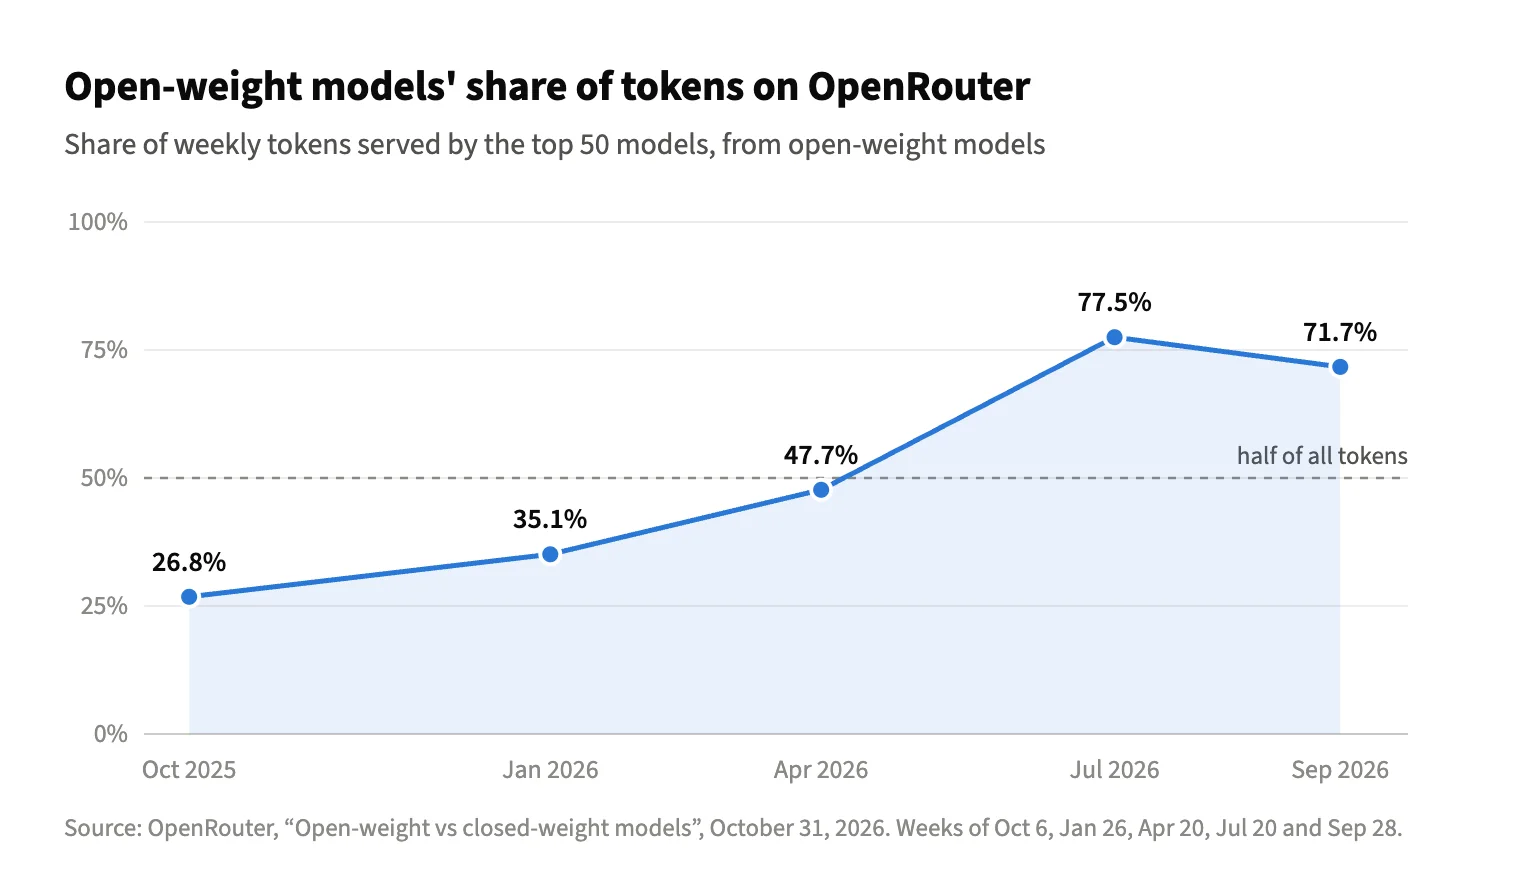
De acuerdo con datos publicados por OpenRouter, la cuota de tokens servidos por modelos de pesos abiertos pasó del 26,8 % en octubre de 2025 al 71,7 % a finales de septiembre de 2026, tras alcanzar un pico del 77,5 % en julio. En ese mismo periodo, el volumen semanal de estos modelos creció más de 60 veces, frente a un incremento cercano a diez veces en los modelos cerrados.
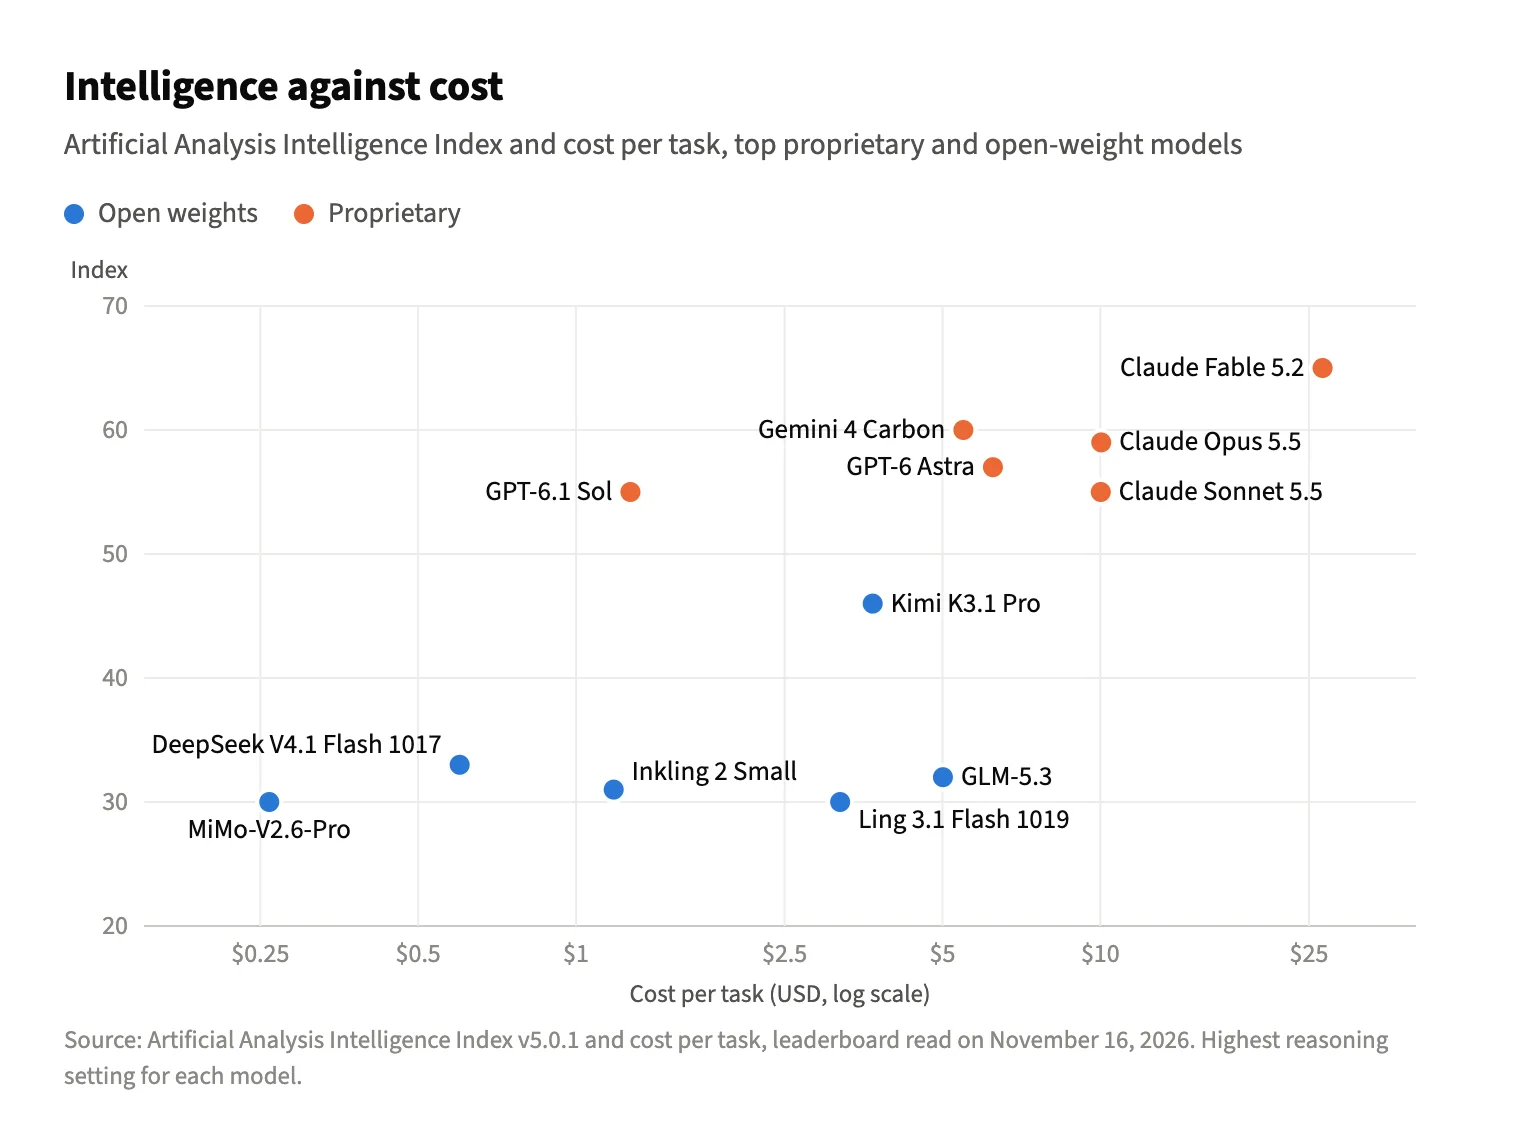
El modelo más utilizado en OpenRouter durante la semana del anuncio fue DeepSeek V4.1 Flash 1017, con 59,2 billones de tokens procesados. En términos económicos, los modelos de pesos abiertos resultan aproximadamente cuatro veces más baratos en promedio, aunque los modelos propietarios líderes aún mantienen ventaja en las pruebas de razonamiento más exigentes, según el índice de Artificial Analysis.
| Métrica comparativa | Modelos de pesos abiertos | Modelos propietarios |
|---|---|---|
| Costo promedio de entrada (por millón de tokens) | 0,28 dólares | 1,27 dólares |
| Costo promedio de salida (por millón de tokens) | 1,62 dólares | 6,36 dólares |
| Mejor puntuación en Artificial Analysis Intelligence Index | 46 (Kimi K3.1 Pro) | 65 (Claude Fable 5.2) |
| Costo por tarea del modelo líder | 3,68 dólares | 26,54 dólares |
Enrutamiento inteligente y caché de contexto
OpenRouter procesa más de 800 billones de tokens mensuales para más de 10 millones de usuarios en más de 600 modelos. Su reciente rediseño de enrutamiento prioriza el equilibrio entre costo, latencia y disponibilidad, logrando reducir los errores de capacidad en un 46 %, mejorar el tiempo hasta el primer token en un 16,9 % y aumentar el rendimiento (throughput) en un 16,3 %.
Los desarrolladores pueden seguir forzando políticas o proveedores específicos añadiendo un sufijo al identificador del modelo:
zai-org/GLM-5.3            # por defecto: equilibrio entre precio, velocidad y fiabilidad
zai-org/GLM-5.3:fastest    # mayor rendimiento
zai-org/GLM-5.3:cheapest   # menor precio
zai-org/GLM-5.3:novita     # únicamente Novita
El sistema también contempla la afinidad de caché (cache-aware routing), manteniendo una conversación en el mismo proveedor que conserva la caché del prompt. Para garantizarlo de forma explícita, basta con enviar un UUID estable por conversación en la cabecera X-HF-Session-Id.
Precios, visibilidad y cambio en llaves personalizadas
Hugging Face no aplica recargos sobre las tarifas de los proveedores y mantiene sin cambios sus créditos mensuales: 2 dólares al mes para usuarios PRO y 2 dólares por puesto para organizaciones Team y Enterprise. Por su parte, la generación de imagen, video y audio sigue operando directamente a través de Hugging Face Inference Providers, conservando el acceso a decenas de miles de LoRAs.
Las páginas de modelos incorporan dos nuevas pestañas de transparencia: Providers, que detalla precios, velocidad y disponibilidad de cada proveedor en las últimas 24 horas, y Metrics, que resume los mejores valores de rendimiento y longitud de contexto. Asimismo, el panel de consumo desglosa el gasto por proveedor y la configuración permite desactivar proveedores específicos a nivel personal o de organización.
El único cambio incompatible (breaking change) afecta a las llaves de API propias para modelos de lenguaje: al facturarse el tráfico a través de OpenRouter en la cuenta de Hugging Face, ya no es posible utilizar claves personalizadas para estos modelos, aunque las llaves propias para proveedores de imagen y video siguen funcionando. Como próximos pasos, ambas compañías planean permitir la vinculación directa de cuentas de OpenRouter con Hugging Face y ampliar las tareas enrutadas por esta vía.
Fuente: Hugging Face