Hugging Face publica una guía de fine-tuning LoRA para TRELLIS.2 que eleva el F-score 3D a 0,803
Hugging Face detalla cómo aplicar fine-tuning con LoRA a TRELLIS.2 en local o en la nube, elevando la fidelidad geométrica 3D con solo 188 objetos.
La generación de activos 3D a partir de una sola imagen avanza rápido en robótica, simulación y entretenimiento, pero los modelos generalistas suelen fallar en detalles geométricos críticos para cada dominio. Aunque arquitecturas como TRELLIS.2 mejoran la fidelidad estructural respecto a su predecesor, carecían de una vía sencilla para adaptarse a categorías específicas de objetos.
Para cubrir esa brecha, Suvaditya Mukherjee, merve y Pedro Cuenca detallan en Hugging Face un flujo completo y contenedores reproducibles, disponibles en trellis2-finetuning, para aplicar fine-tuning mediante LoRA (low-rank adaptation). La solución funciona tanto en GPU local como en Hugging Face Jobs para especializar modelos 3D con conjuntos reducidos.
El desafío de estandarizar el 3D y el problema de las suelas
Estandarizar representaciones tridimensionales resulta complejo por la variedad de formatos de archivo, como GLB y PLY, y de técnicas como los neural radiance fields (NeRFs) o el 3D Gaussian splatting (3DGS). TRELLIS resolvió esa fragmentación mediante una representación latente unificada cuyos decodificadores exportan al formato final requerido sin entrenar un modelo distinto por cada salida.
Su sucesor, TRELLIS.2, perfeccionó la estructura 3D, aunque mantuvo errores cuando una aplicación exige geometría exacta. Al probar el modelo preentrenado con un subconjunto de 188 piezas de calzado extraídas de los 1.030 objetos de Google Scanned Objects (GSO), el equipo observó que la silueta superior lucía bien, pero las suelas resultaban incorrectas.
Arquitectura de TRELLIS.2, formato O-Voxel y selección de capas
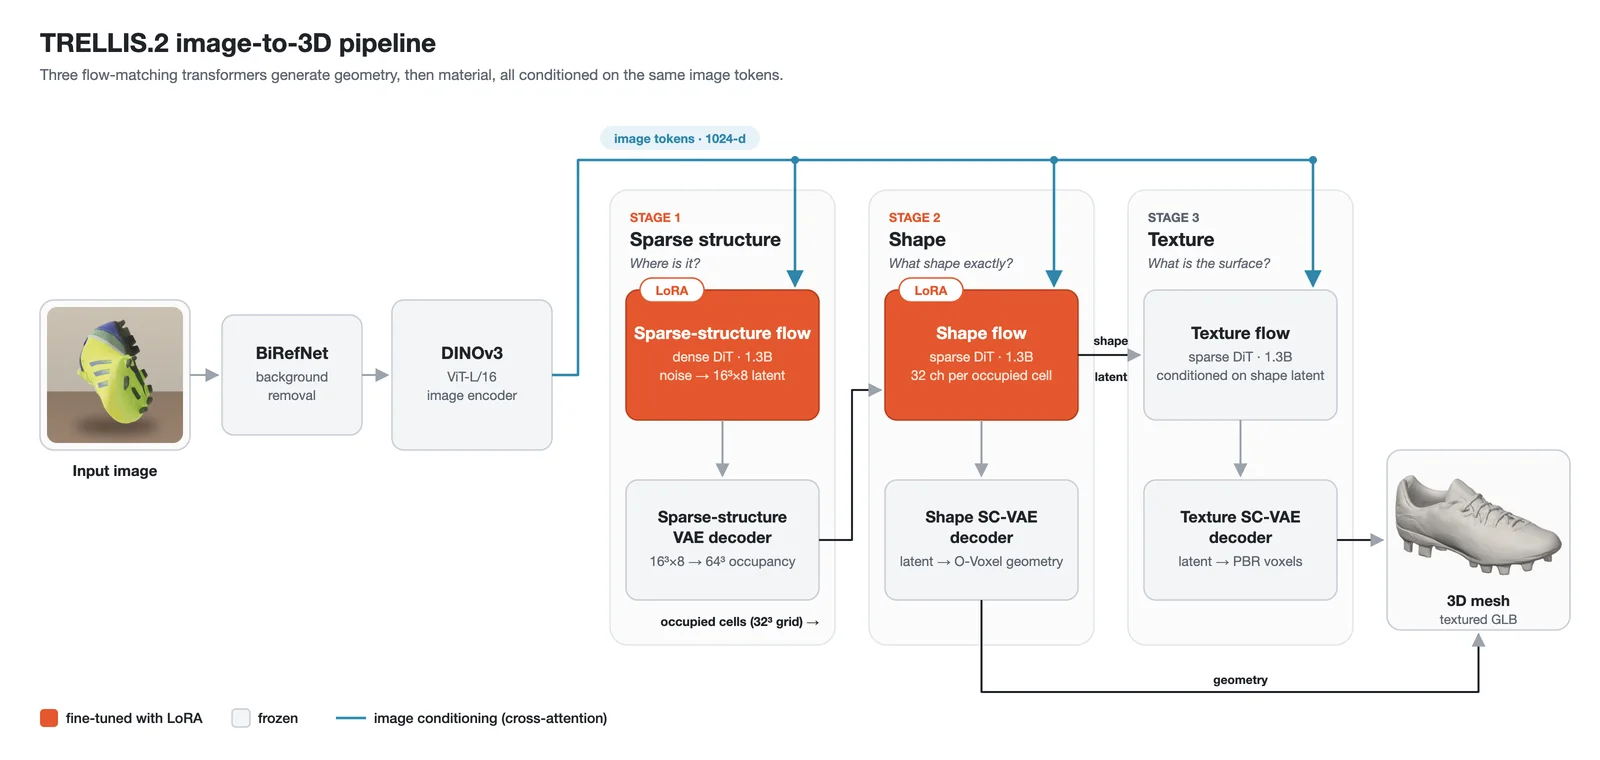
Antes de exportar una malla texturizada (textured mesh) en formato GLB, el pipeline de TRELLIS.2 encadena cinco fases: eliminación de fondo con BiRefNet, codificación visual en feature tokens mediante DINOv3-L, predicción de estructura gruesa (Sparse Structure Flow), generación de geometría fina (Shape Flow) y síntesis de materiales (Texture Flow).
En el núcleo del modelo opera O-Voxel, una cuadrícula dispersa (sparse voxel grid) que conserva únicamente los vóxeis situados sobre la superficie del objeto junto a su geometría local y atributos de material. Gracias a esta compacidad y a los latentes estructurados dispersos —que aprovechan cerca del 10 % de los vóxeis totales y evitan calcular espacio vacío—, una CPU o GPU convierte entre malla y O-Voxel en segundos.
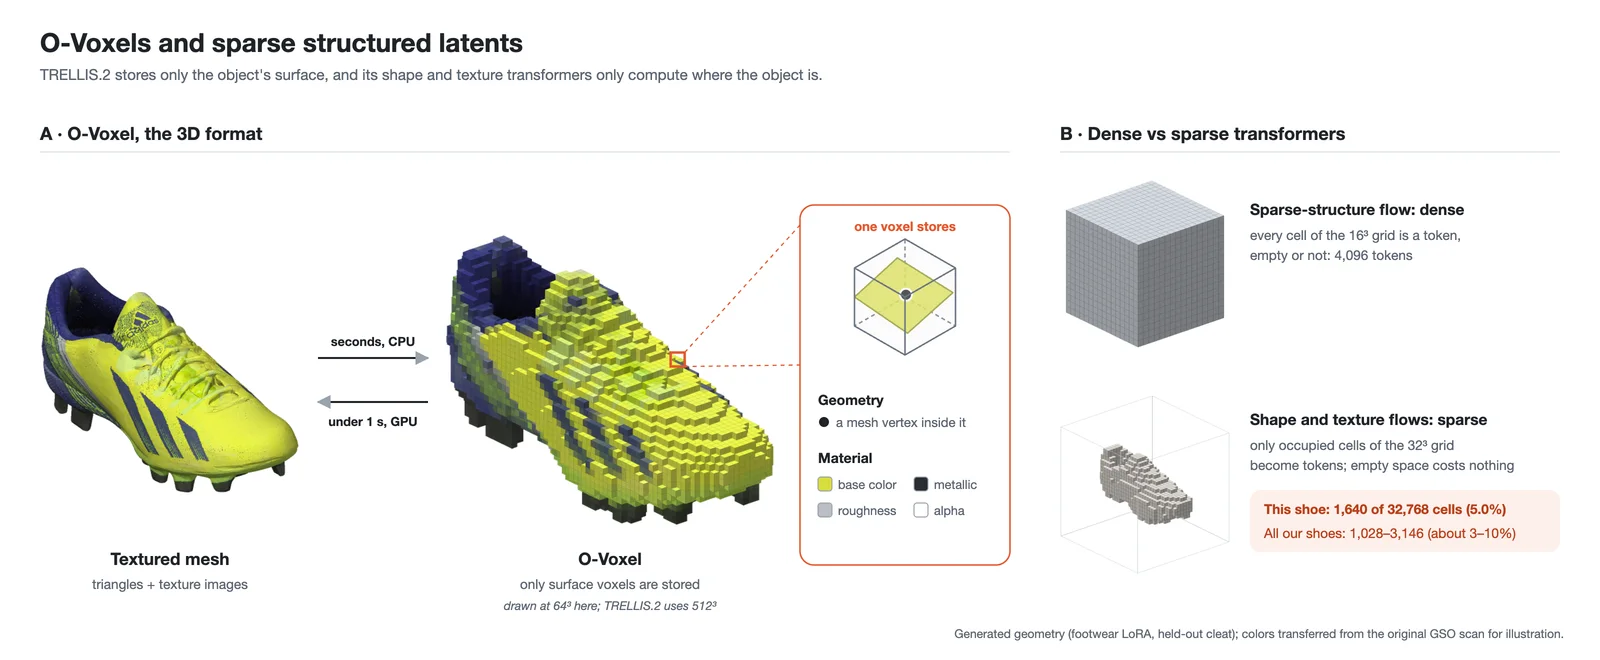
El equipo resume el criterio del experimento en una regla práctica: «Elegir qué congelar importa tanto como elegir qué ajustar». Como el conjunto GSO solo aporta mapas de color difuso con iluminación ya horneada (baked lighting) y carece de mapas separados de color base, metalicidad (metallic), rugosidad (roughness) y transparencia (alpha), entrenar la etapa de textura provocaría catastrophic forgetting y confundiría sombras con superficie.
Por ello, la estrategia congela por completo Texture Flow y los pesos base, limitando el fine-tuning con adaptadores LoRA a las dos etapas que gobiernan la estructura y el contorno tridimensional. Con 179 objetos de entrenamiento y 9 reservados en holdout para validación, la configuración entrena unos 9,3 millones de parámetros sin sobrescribir los learned priors originales:
| Etapa del pipeline | Tipo de DiT y salida | Adaptación LoRA | Cómputo y tiempo (1× A100 80 GB) |
|---|---|---|---|
Sparse Structure Flow (ss) | DiT denso; latente 16³ × 8 y rejilla de ocupación 64 × 64 × 64 | Rango 8 en capas de atención y MLP (calendario logitNormal) | 7,2 horas |
Shape Flow (shape) | DiT disperso (~10 % vóxeis); geometría O-Voxel 512 × 512 × 512 | Rango 16 en capas de atención (calendario uniform) | 3,6 horas |
| Texture Flow | DiT disperso; mapas de color base, metallic, roughness y alpha | Congelado (sin adaptadores LoRA) | Sin reentrenamiento |
Preprocesamiento con Blender y ejecución en Hugging Face Jobs o Docker
Para evitar configuraciones complejas de dependencias 3D, el tutorial distribuye dos imágenes Docker independientes (trellis2-finetuning-prep y trellis2-finetuning-train) compatibles con GPUs locales y con Hugging Face Jobs. Como requisito previo, el usuario necesita un token HF_TOKEN, acceso aprobado al modelo restringido DINOv3 y sus mallas cargadas en el Hub.
El primer contenedor automatiza el rendering de 16 vistas de condicionamiento por objeto mediante Blender en modo headless (xvfb-run) y las procesa con el toolkit de datos de TRELLIS.2. Para los 188 modelos de calzado, esta codificación tardó aproximadamente 1 hora en una instancia a100-large de 80 GB con 8 workers y un 5 % de reserva (--holdout 0.05).
Los latentes precalculados se guardan en el Hub —como en el repositorio público gso-footwear-trellis2-latents— para reutilizarlos sin recodificar mallas en futuras pruebas. Luego se ejecutan dos trabajos separados con el contenedor de entrenamiento (--config ss y --config shape), referenciando los archivos ss_flow_lora_gso.json y slat_flow_img2shape_lora_gso.json con reanudación automática y registro de métricas en Trackio.
# 1. Preprocesamiento de mallas a latentes y 16 vistas con Blender
hf jobs run -d --flavor a100-large --timeout 6h --secrets HF_TOKEN \
  cr.hf.co/suvadityamuk/trellis2-finetuning-prep:latest \
  trellis2-prep --meshes usuario/mis-mallas --push-to usuario/mis-latentes \
  --private --holdout 0.05 --views 16 --workers 8

# 2. Entrenamiento LoRA independiente para cada etapa (ss y shape)
hf jobs run -d --flavor a100-large --timeout 12h --secrets HF_TOKEN \
  cr.hf.co/suvadityamuk/trellis2-finetuning-train:latest \
  trellis2-train --config ss --latents usuario/mis-latentes \
  --push-to usuario/mi-trellis2-lora --run-name ss_lora --push-path ss_lora
En máquinas propias con GPU, el flujo conserva los mismos argumentos sustituyendo el lanzador por docker run --gpus all --rm --shm-size 16g y montando la caché de Hugging Face. Los scripts compactos preprocess.py y finetune.py permiten inspeccionar el código fuera del contenedor, y los adaptadores entrenados están disponibles en suvadityamuk/trellis-2-finetune-gso.
Cómo funciona el bucle de entrenamiento y la inyección LoRA
Dentro del cargador de datos, cada iteración selecciona al azar una de las 16 vistas de Blender como imagen de condicionamiento y excluye las piezas listadas en holdout.txt. La configuración emplea un tamaño de lote de 4 con 4 pasos de acumulación de gradientes (num_workers=4), lo que equivale a un batch efectivo de 16 muestras.
Debido a que TRELLIS.2 utiliza un forward pass personalizado incompatible con PeftModel(), la integración recurre a inject_adapter_in_model() de la biblioteca peft. Los pesos entrenables LoRA se conservan en fp32 por estabilidad numérica, mientras el cálculo directo aplica autocasting en bf16 junto a use_checkpoint = True (gradient checkpointing) para ahorrar memoria en GPU.
El objetivo de optimización replica el rectified flow matching del preentrenamiento de TRELLIS.2, una técnica también usada en generadores de imagen como Stable Diffusion 3 y Flux 2. Tras extraer características con DinoV3FeatureExtractor y aplicar classifier-free guidance (CFG) dropout con probabilidad p_uncond, el bucle mezcla datos limpios y ruido gaussiano según un paso temporal t.
En cada iteración, el modelo predice la velocidad escalada en t * 1000 y minimiza el error cuadrático medio (F.mse_loss) respecto a la velocidad objetivo mediante AdamW (betas=(0.9, 0.95)) y recorte de gradientes (clip_grad_norm_). El entrenamiento registra la pérdida cada 10 pasos y guarda un checkpoint del adaptador cada 500 pasos —con ejecuciones configuradas hasta 3.000 iteraciones mediante max_steps=3000—.
Resultados visuales y evaluación geométrica sobre objetos no vistos
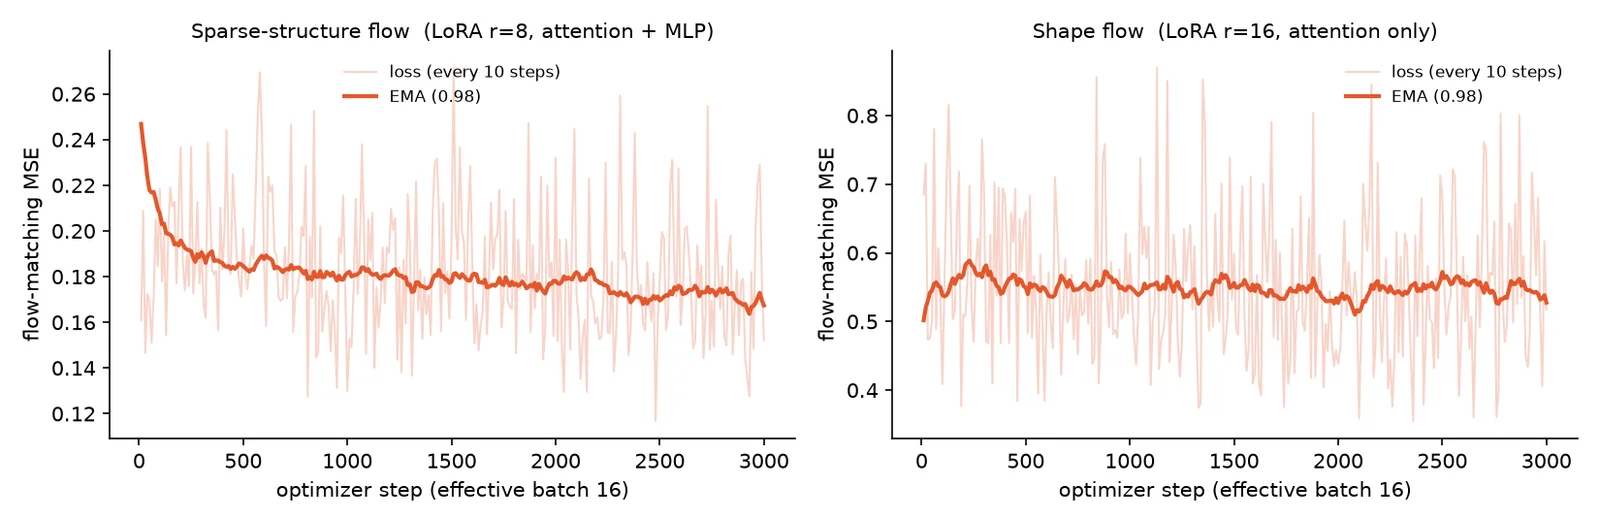
Las curvas de entrenamiento muestran una caída rápida inicial en Sparse-Structure Flow que luego se modera, mientras que la pérdida de Shape Flow se mantiene prácticamente estable. No obstante, al variar según los objetos muestreados, el ruido y los pasos temporales t, la pérdida de flow matching no mide directamente la calidad 3D obtenida.
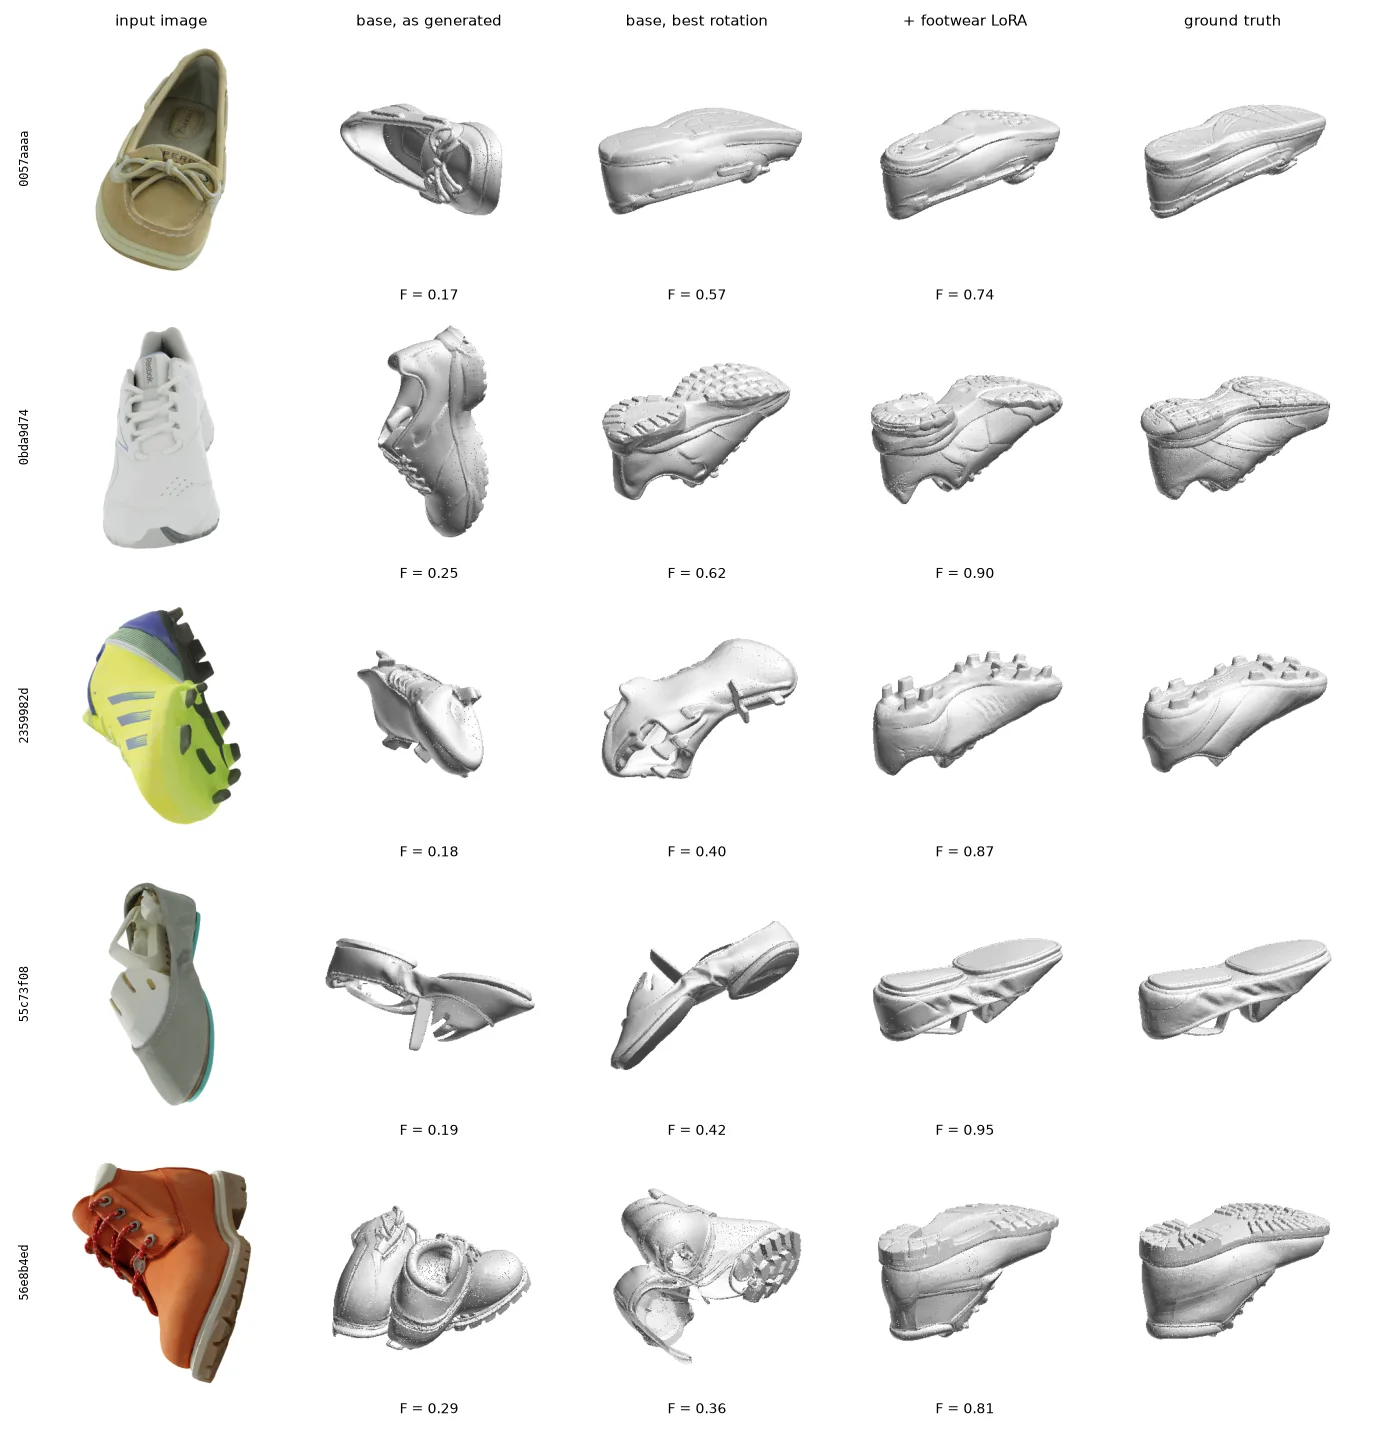
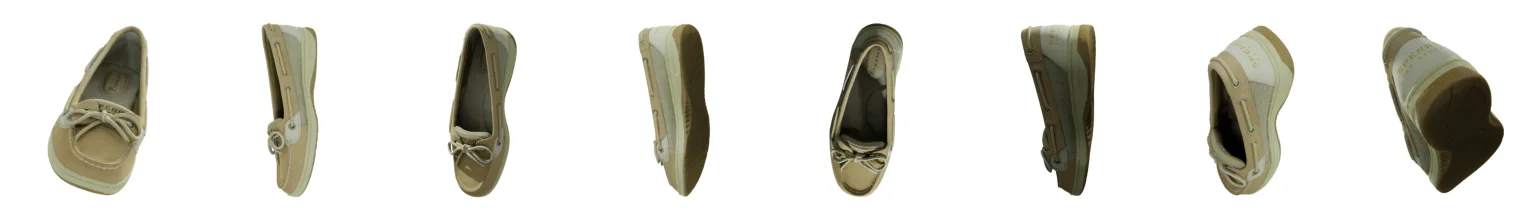
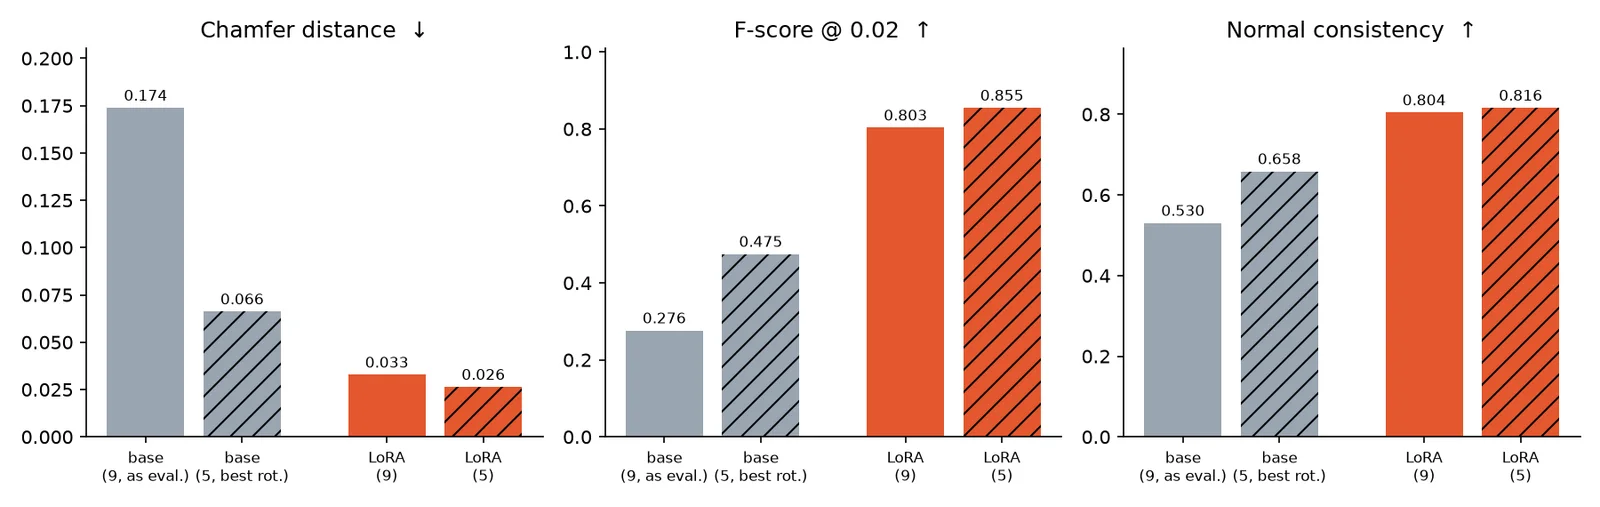
La inspección visual sobre cinco de los nueve objetos de prueba demuestra que los adaptadores LoRA reconstruyen las suelas con mucha mayor fidelidad al escaneo de referencia que el modelo base, incluso tras ajustar su rotación. Para cuantificar esa mejora en las nueve piezas reservadas, la evaluación aplicó tres métricas cuyos registros completos figuran en Trackio:
| Métrica geométrica | Qué mide | Modelo base | TRELLIS.2 + LoRA |
|---|---|---|---|
| F-score @ 0.02 (↑ mejor) | Precisión y cobertura superficial dentro del 2 % de la diagonal del objeto | 0,276 | 0,803 |
| Distancia de Chamfer (↓ mejor) | Distancia bidireccional media entre puntos de ambas superficies | 0,174 | 0,033 |
| Consistencia normal (↑ mejor) | Grado de alineación entre vectores normales perpendiculares a la superficie | 0,530 | 0,804 |
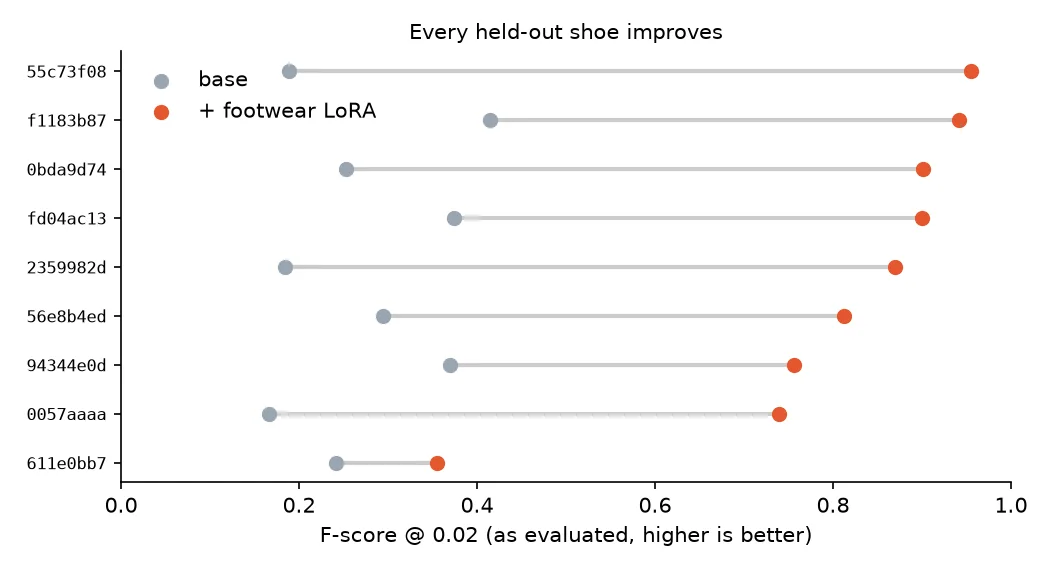
El desglose individual confirma que la combinación de ambos adaptadores supera al modelo base en el F-score de cada uno de los nueve objetos de evaluación sin excepción.
Próximos pasos en generación 3D
La conclusión principal del experimento es seleccionar las capas entrenables en coherencia con el problema y los datos disponibles, ajustando estructura y forma mientras se preservan las texturas originales. Como líneas futuras, los autores plantean probar esta misma estrategia en modelos 3D como Pixal3D y UniLat3D, además de estudiar adaptaciones específicas para sistemas de Gaussian splatting y generación de mundos como HunyuanWorld 2.0 y NVIDIA Lyra 2.0.
Fuente: The Definitive Fine-Tuning Guide for 3D Generation Models