Anthropic demuestra que la clave de la memoria en agentes de IA es saber qué olvidar
Anthropic prueba cómo Claude retiene conocimiento entre sesiones: notas selectivas y el proceso Dreaming superan al almacenamiento exhaustivo.
Cualquier usuario que trabaje con un agente de inteligencia artificial durante varios días tropieza rápido con un límite estructural: cada nueva sesión parte desde cero. En una investigación publicada por Anthropic y recogida por The Decoder, la compañía detalla cómo Claude puede conservar conocimiento entre sesiones mediante archivos de notas sin modificar los pesos del modelo.
El desafío central reside en la selección. Antes de saber qué ocurrirá después, el agente debe decidir sobre la marcha qué información resultará útil en el futuro, por lo que cada apunte actúa como una apuesta que puede quedar obsoleta o inducir a error.
Los agentes que lo guardan todo pierden el rumbo
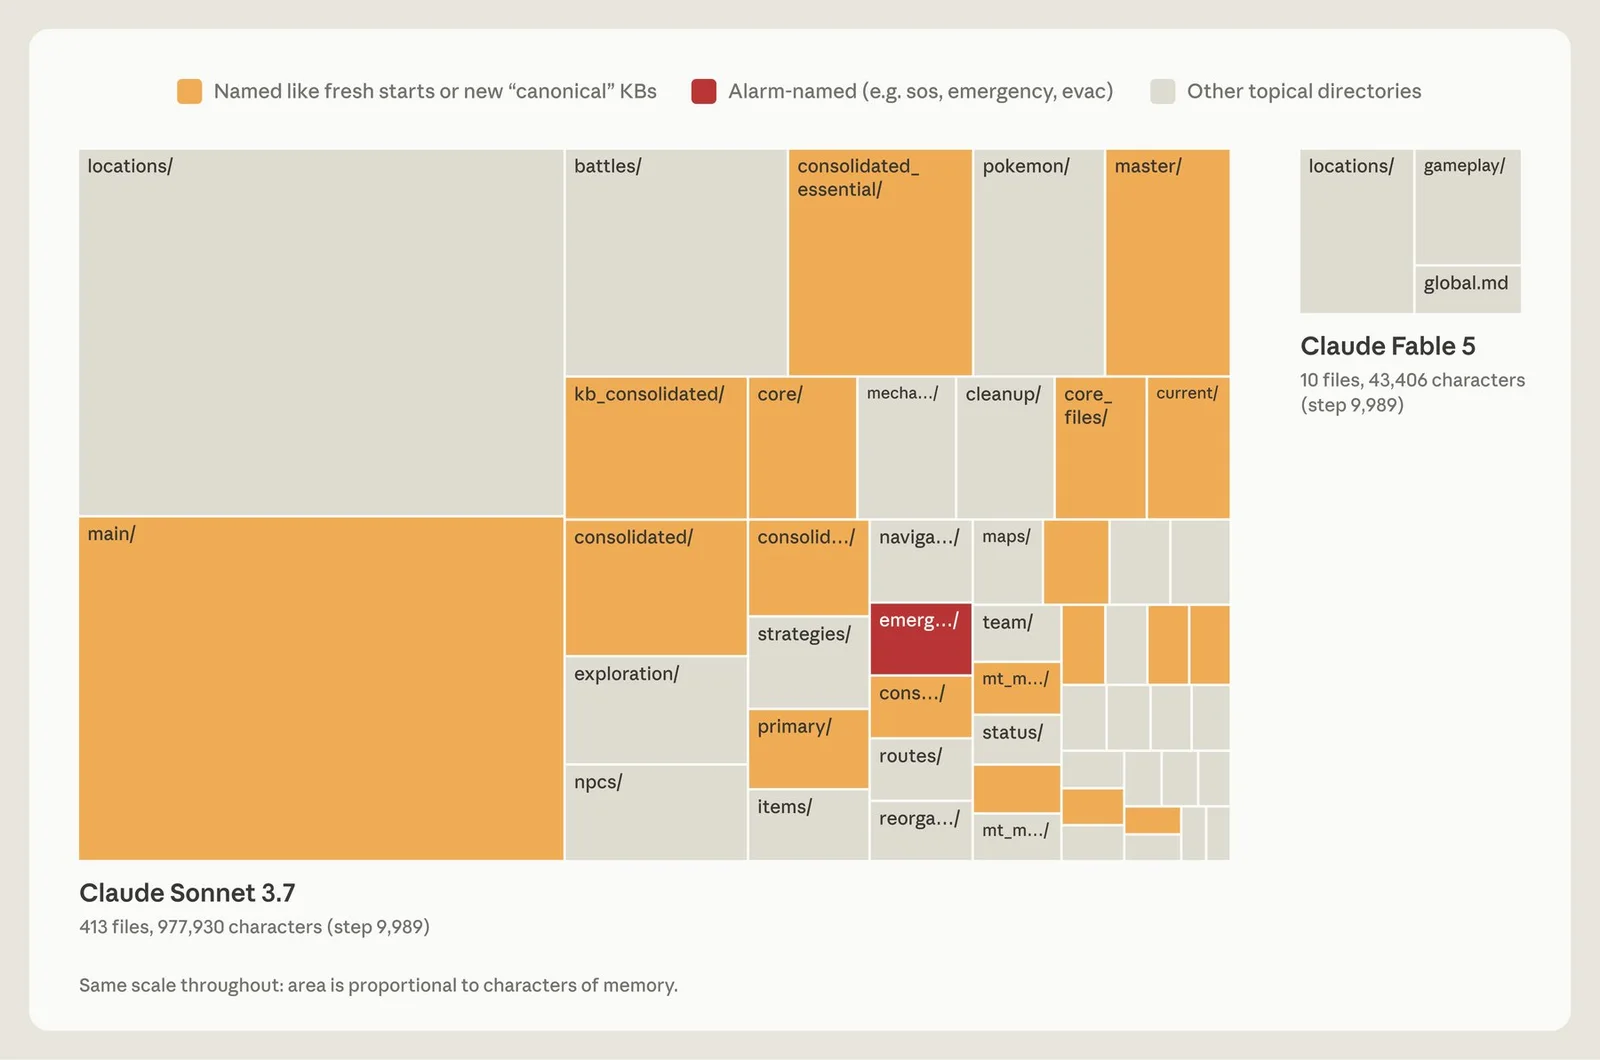
Para comprobar qué estrategia funciona mejor, Anthropic evaluó distintas generaciones de Claude en partidas de Pokémon Red de aproximadamente 10.000 pasos. Mientras el modelo más antiguo trató cada combate y cada objeto como información crítica, la versión más reciente evitó registrar datos ya visibles en pantalla y se limitó a anotar planes, estrategias y reglas verificadas.
| Modelo evaluado | Archivos generados | Carpetas | Tamaño aproximado | Medallas obtenidas |
|---|---|---|---|---|
| Claude Sonnet 3.7 | 413 | 225 | 978.000 caracteres | 1 |
| Claude Fable 5 | 10 | — | 43.000 caracteres | 4 |
Debido a que el estado del juego cambia de forma constante, el archivo masivo de Claude Sonnet 3.7 envejeció con rapidez. En varios tramos, el modelo dedicó todo su esfuerzo a reorganizar carpetas en lugar de avanzar, aunque Anthropic advierte que la comparativa cubre una única partida por modelo.
A partir de estas pruebas, la empresa recomienda explicar al agente para qué sirve su memoria y dejar que decida cómo gestionarla. En un benchmark con Sonnet 4.6, añadir memoria con instrucciones refinadas elevó la puntuación de 0,330 a 0,641 frente a 0,364 con memoria básica, pero imponer reglas rígidas como «anotar solo los errores» anuló casi toda la ganancia en los modelos más capaces.
«Dreaming» busca corregir los recuerdos falsos
El mayor riesgo de la memoria persistente aparece cuando un agente confía a ciegas en un apunte incorrecto. En la prueba de Pokémon Red, Claude anotó mal en qué lado de una montaña se encontraba un punto de referencia, cayó tres veces en la misma trampa cerca del Monte Moon y estuvo a punto de abandonar antes de alcanzar Ciudad Celeste.
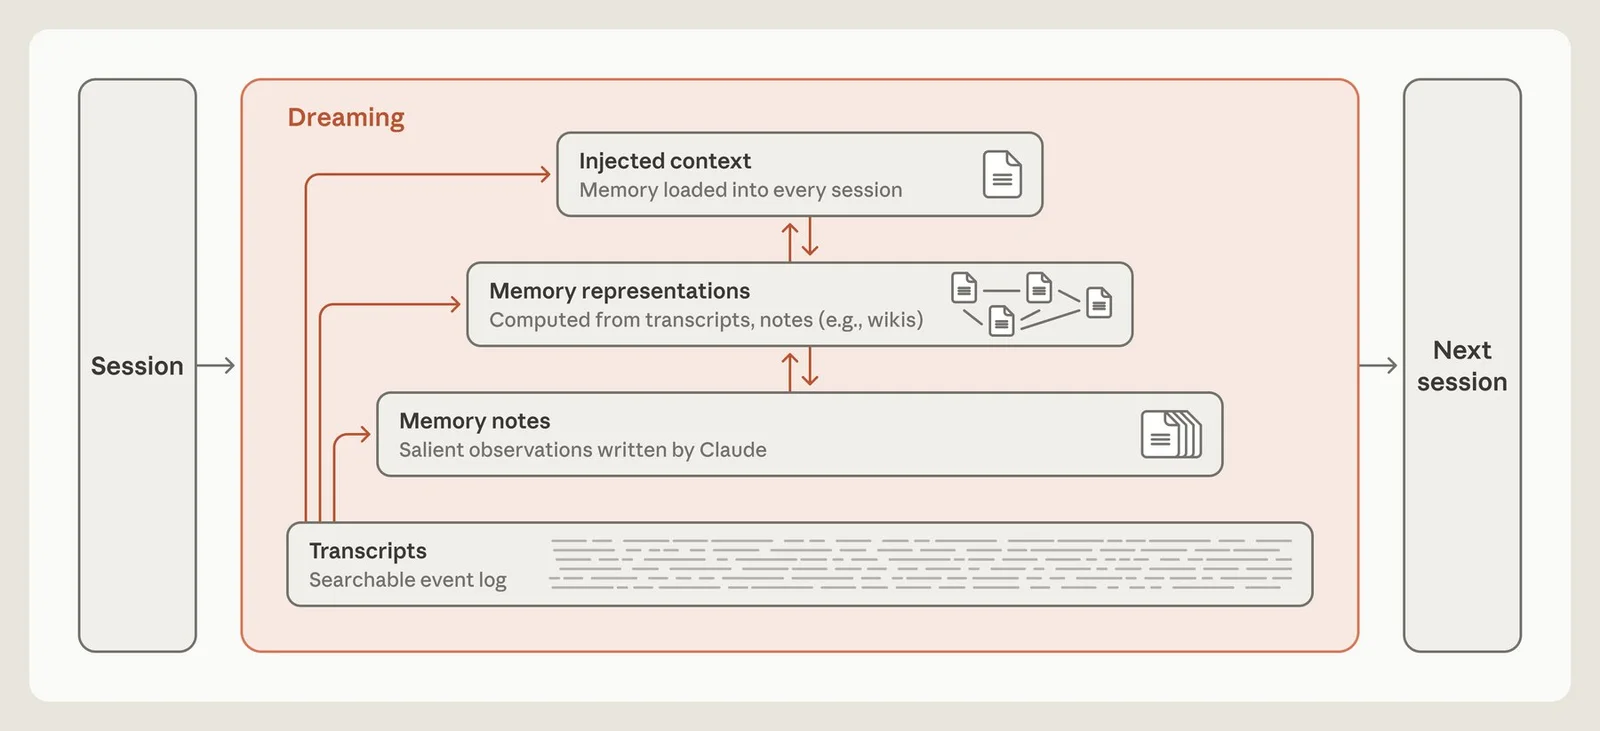
Para resolverlo, Anthropic aplica Dreaming, un concepto inspirado en investigaciones de Letta y la Universidad de California en Berkeley. Durante los periodos de inactividad entre sesiones, el sistema revisa las transcripciones previas, contrasta sus propias notas con lo ocurrido y corrige los fallos antes de reconstruir capas superiores de conocimiento.
En el experimento del juego, solo la ejecución que combinó memoria con la corrección posterior de Dreaming logró completar el trayecto hasta Ciudad Celeste tras 1.935 acciones. Las variantes sin memoria o con notas sin depurar no alcanzaron el objetivo dentro del límite de 3.000 acciones.
Wikis corporativas frente a búsqueda tradicional
Anthropic también probó si Dreaming sirve para estructurar grandes repositorios documentales. Claude generó una wiki enlazada a partir de unos 350.000 documentos internos de Stainless —empresa de software adquirida por Anthropic— creando nuevas páginas y reparando duplicados, lagunas y enlaces rotos entre sesiones.
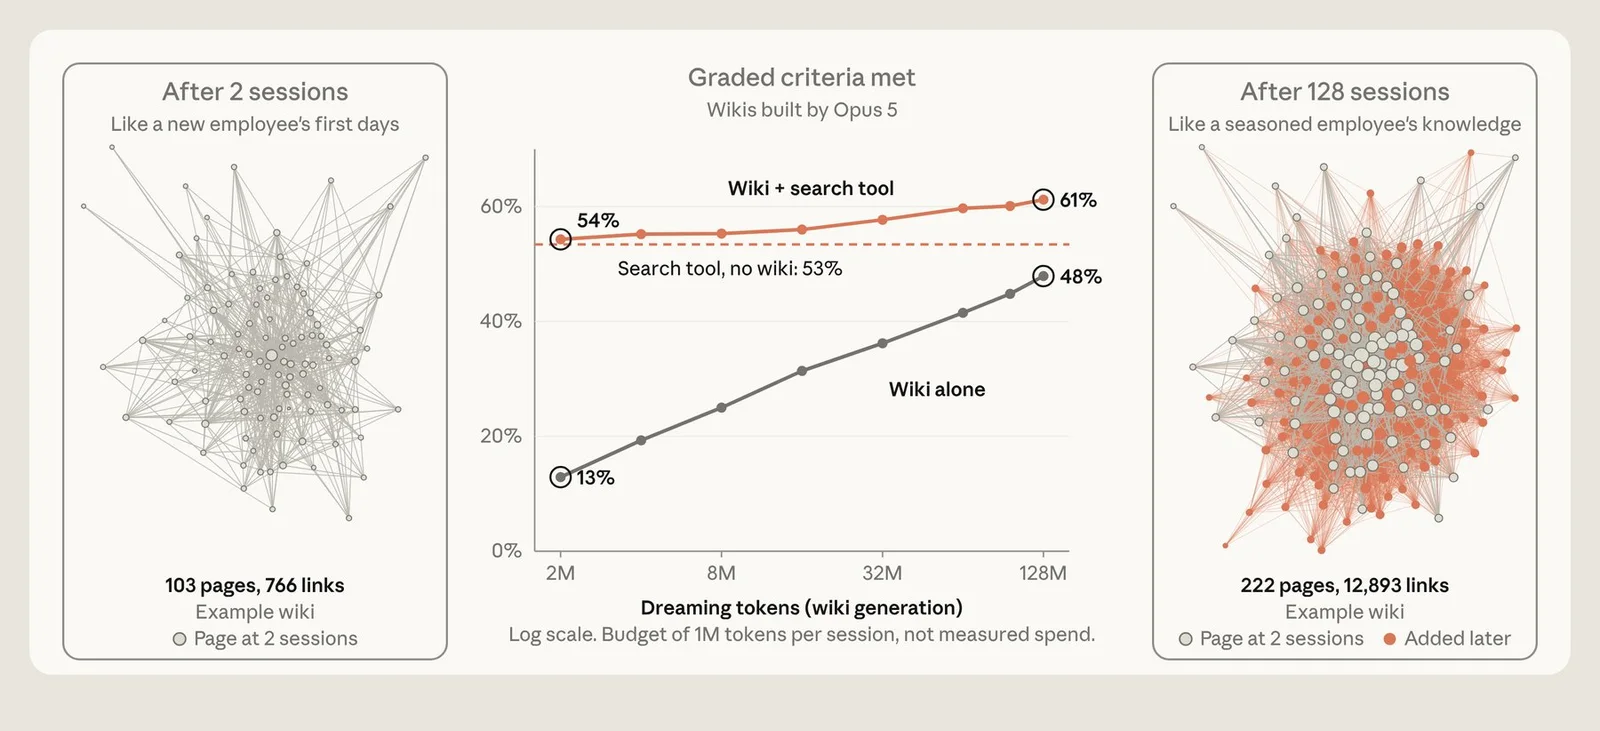
Los resultados mostraron que la wiki funciona mejor como complemento que como sustituto de los buscadores. En una evaluación de 25 preguntas sobre ese corpus, combinar wiki y búsqueda pasó del 54 % al 61 % de criterios cumplidos, mientras la wiki aislada subió del 13 % al 48 % y la búsqueda sola se mantuvo en el 53 %; en una prueba legal separada con respuestas repartidas entre varios documentos, la wiki alcanzó el 87 % frente al 73 % de la búsqueda directa, aunque en búsquedas simples (lookup) rindió de forma similar y llegó a ocupar más espacio que los archivos originales.
Límites técnicos y competencia en la industria
Anthropic reconoce que la memoria de agentes sigue lejos de estar resuelta. Tomar notas en mitad de una tarea distrae al modelo, Dreaming consume cómputo adicional con resultados diferidos y cargar demasiados recuerdos al inicio consume ventana de contexto y propaga cualquier error a sesiones futuras.
La compañía lanzó Dreaming en mayo como vista previa de investigación dentro de Claude Managed Agents, su plataforma cloud para agentes autónomos, donde lee hasta 100 sesiones pasadas para depurar almacenes de memoria sin alterar el original (inicialmente compatible solo con Claude Opus 4.7 y Sonnet 4.6). En paralelo, OpenAI utiliza el mismo término para la memoria de ChatGPT renovada en junio —elevando la precisión temporal del 52,2 % al 75,1 %—, mientras Google y Google DeepMind exploran estrategias similares junto a WikiSkill, una arquitectura por capas que separa transcripciones, conocimiento destilado e instrucciones.
Fuente: The Decoder