Hugging Face presenta Transformers Model Integration Contracts para estandarizar pruebas de modelos en CPU
Hugging Face estandariza las pruebas de integración en Transformers con modelos reducidos en CPU que detectan regresiones silenciosas en segundos.
El 30 de julio de 2026, la biblioteca transformers activó por defecto la atención de producto escalar escalado (scaled dot-product attention, SDPA) de PyTorch para la arquitectura T5. Como efecto secundario imprevisto, el decodificador de UMT5 pasó a poder atender a future tokens durante el entrenamiento y predecir respuestas viendo información futura, sin lanzar errores ni provocar fallos visibles durante casi dos meses en la rama main.
Para impedir que regresiones silenciosas de este tipo superen la integración continua, Tarek Ziadé detalla en Hugging Face el estándar propuesto transformers-mic (Model Integration Contracts). Al reproducir el historial de commits con un modelo reducido en CPU bajo esta especificación, el fallo de UMT5 quedó expuesto en cada revisión afectada.
El cuello de botella en GPU y las limitaciones de los modelos diminutos
Actualmente, transformers da soporte a más de 750 tipos de modelos con una batería que supera las 88.000 pruebas en CPU sobre main y las 200.000 pruebas diarias en GPU. Estas evaluaciones cubren pipelines, entrenamiento, ejecución distribuida, cuantización y attention kernels sobre CPU, NVIDIA GPU, AMD GPU, Intel XPU y Gaudi 3.
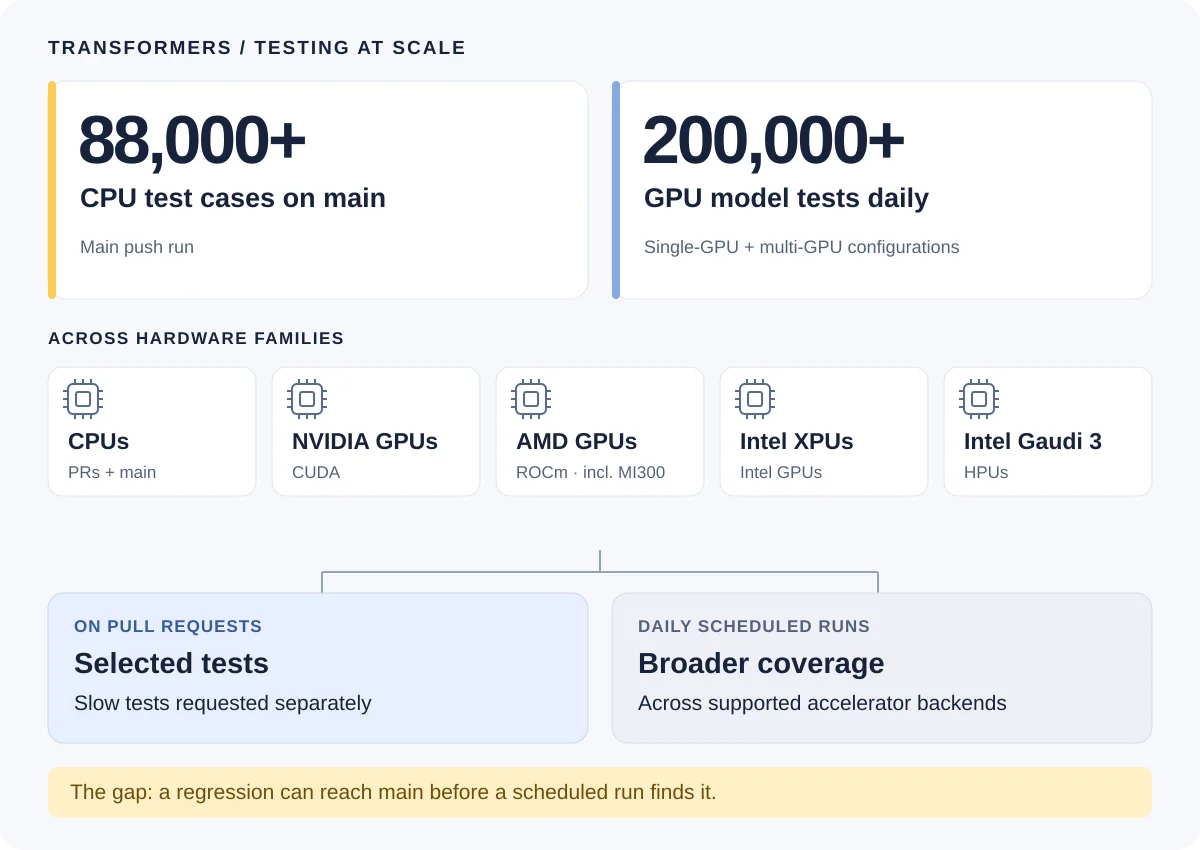
Ejecutar pruebas de integración reales —cargando checkpoints completos sobre aceleradores— en cada pull request saturaría las flotas de GPU durante todo el día. Por esa razón, las validaciones completas se difieren a ejecuciones programadas, lo que permite que una regresión alcance main antes de ser detectada.
Aunque los integradores ya creaban modelos diminutos manualmente (tiny-random-*), esas pruebas suelen limitarse a cargar pesos y ejecutar un forward pass, un filtro que UMT5 superaba sin alarmas. Los nuevos fixtures comprimidos del estudio en CPU ejecutan fast integration tests —incluso para modelos gigantes incompatibles con runners GPU estándar—, complementando sin sustituir las pruebas completas.
Anatomía de un Model Integration Contract y ejemplo con SmolLM
Un Model Integration Contract (MIC) vincula una arquitectura de red neuronal con una ruta de uso concreta, no con un único checkpoint. De este modo, distintos pesos compatibles pueden compartir un mismo modelo reducido en huggingface-mic mientras conservan sus propios resultados esperados independientes.
Para garantizar que cada ejecución en integración continua pueda reproducirse en el futuro, el diseño separa el modelo comprimido, la secuencia de uso y las métricas de referencia bajo un registro versionado en el Hub:
| Componente del estándar | Artefacto o ubicación | Función en el contrato | Criterio de validación |
|---|---|---|---|
| Fixture | Pesos comprimidos fijados en huggingface-mic | Replicar tipos de capa y preprocesamiento con tamaño mínimo | Publicado una sola vez y reutilizado sin reconstruirse en cada pull request |
| Usage path | Archivo ejecutable usage.md en Markdown | Definir un flujo real de usuario (inferencia o entrenamiento) | Se ejecuta íntegramente sobre el fixture tras cada cambio |
| Baselines | Salidas y métricas revisadas por humanos | Servir de referencia determinista por plataforma y precisión | El contrato se cumple si las salidas siguen coincidiendo |
| Fleet dataset | huggingface-mic/transformers-fleet | Fijar la revisión congelada y versiones de paquetes de cada MIC | Cada trabajo de CI registra la revisión exacta empleada |
El contrato de SmolLM, documentado en usage.md, ilustra este enfoque comprobando generación determinista a partir de prompts como «The capital of France is». Además de comparar identificadores de tokens, valida la pérdida de entrenamiento (training loss), confirma gradientes finitos y verifica que el paso del optimizador modifica los pesos:
inputs = tokenizer("The capital of France is", return_tensors="pt")
outputs = model.generate(**inputs, max_new_tokens=4, do_sample=False)
new_tokens = outputs[:, inputs["input_ids"].shape[1]:]
print(tokenizer.batch_decode(new_tokens, skip_special_tokens=True))
Cuando se abre un pull request, la infraestructura de integración continua selecciona únicamente los contratos MIC vinculados a los archivos modificados por el parche. Este filtrado selectivo evita reevaluar todo el catálogo de modelos y mantiene tiempos de respuesta ágiles en CPU.
Receta de compresión en cuatro fases y flujo con tmic
Reducir indiscriminadamente dimensiones y capas falla en arquitecturas mixtas: conservar solo dos capas resulta inútil si ambas aplican sliding attention y desaparecen las de full attention. Para resolverlo, la receta oficial de fixtures aplica un proceso sistemático en cuatro etapas:
- Reducir la configuración: Partir de un checkpoint real disminuyendo anchura oculta, cabezas de atención y profundidad, preservando cada tipo de capa —incluidas mezclas de sliding y full attention o bloques densos y MoE— y consultando
ModelTesterentest_modeling_<model>.pypara atributos específicos. - Mantener intacto el preprocesamiento: Conservar vocabulario, tokens especiales y dimensiones de entrada, realizando una copia binaria exacta de los archivos del tokenizer y del procesador para validar también la carga y preparación de datos.
- Construir, validar y preservar formato de pesos: Inicializar con pesos aleatorios fijados por semilla —o entrenar brevemente sobre el batch del contrato si el modelo no reacciona a cambios de entrada— manteniendo el formato original de archivo para ejercitar la conversión real de carga y rechazando salidas o gradientes no finitos.
- Congelar y registrar: Guardar los pesos aceptados sobre una versión validada de
transformers, revisar manualmente las baselines por plataforma y precisión, y publicar una instantánea fijada que la CI reutiliza sin reconstruir.
Para automatizar la creación de contratos, la herramienta de línea de comandos tmic coordina agentes basados en LLM mediante Inference Providers. El modelo redacta el código de uso y el manifiesto, pero nunca aprueba los resultados: toda variación en las baselines medidas en CPU o GPU requiere revisión humana obligatoria.
pip install "transformers-mic[runtime]" "hf-doc-builder @ git+https://github.com/huggingface/doc-builder.git"
hf auth login
tmic run org/model --local-only --fixtures-only --no-history --bill-to ''
En ejecución local, estos comandos generan el borrador del contrato —facturando el uso del LLM a la cuenta propia con --bill-to ''—, construyen el fixture y detienen el flujo antes de subir archivos, según la documentación de tmic. Cuando los agentes encontraron casos límite entre familias de modelos, el equipo corrigió la receta general junto a especialistas y registró los avances en el espacio de cobertura.
Evidencia experimental: regresión UMT5, Llama 4 Scout y pesos de Whisper
Al reproducir cinco meses de historial entre el commit del 30 de julio de 2026 y la corrección del 28 de septiembre, UMT5 demostró que el fixture debe recorrer la ruta real del código. Ejecutado con SDPA, el contrato falló tanto en el análisis histórico como en una prueba en la CI de Transformers, mientras que la variante eager attention ocultaba el error según los resultados de evidencia.
La técnica también se validó en arquitecturas multimodales de gran escala como Llama-4-Scout-17B-16E-Instruct, preservando cada familia de capas y su enrutamiento MoE en el reporte de reducción. En paralelo, un estudio de inicialización de pesos en Whisper mostró que las matrices aleatorias apenas respondían a cambios de audio, motivando pruebas con sobreajuste (overfit) que asociaban tonos simples a palabras como «red» y «green»:
| Caso evaluado | Compresión o muestra | Desempeño o variación registrada | Alcance y hallazgos clave |
|---|---|---|---|
| UMT5 (fixture CPU con SDPA) | De 1.227 MB originales a 66 MB en el fixture | Diferencia de 1,22 en log-probabilities y 0,20 en loss | Paso de evaluación completado en 13,4 segundos en CPU (sin preparación previa del entorno) |
| Llama 4 Scout (17B-16E) | De 108.600 millones a 44,7 millones de parámetros | Visión de 34 a 2 capas; lenguaje de 48 a 4 capas | Mantiene tipos de capa mixtos y enrutamiento MoE |
| Whisper (random frente a overfit) | 24 fallos sintéticos inyectados en pruebas | Aleatorios: 18 de 24; overfit: 24 de 24 detectados | Ambos pasaron por alto un fallo real de assisted decoding |
Aunque el overfit con ejemplos mínimos —como «The capital of France is» hacia «Paris»— mejora la sensibilidad en señales poco reactivas, añade riesgo de no convergencia y carga de mantenimiento. Como ninguna regresión real ha requerido aún esa técnica según la comparativa técnica de pesos, Hugging Face mantiene pesos aleatorios fijados por semilla cuando superan los controles de respuesta y reserva el sobreajuste para escenarios específicos.
Despliegue no bloqueante y preguntas abiertas en Transformers
Desde el 1 de noviembre de 2026, el trabajo MIC en la CI de Transformers informa los fallos detectados sin bloquear la integración de pull requests. Antes de convertir esta verificación en un filtro obligatorio, el equipo necesita medir cuántos errores reales intercepta en pull requests activos frente a análisis retrospectivos, cuántas falsas alarmas genera y qué carga operativa impone revisar baselines.
También queda por determinar qué proporción de fallos solo afloran con pesos reales —como ocurrió con el error de assisted decoding en Whisper— y si el sobreajuste captura fallos auténticos invisibles para pesos aleatorios. Dado que la cobertura sigue siendo parcial entre familias de modelos y APIs, las pruebas actuales continuarán vigentes mientras se agregan nuevos usage paths ante cualquier regresión que escape.
A medio plazo, Hugging Face prevé enlazar directamente las fichas de modelos del Hub con sus contratos MIC correspondientes. De ese modo, tanto desarrolladores como agentes contarán desde el inicio con un ejemplo verificado sobre ese checkpoint, su entorno exacto y las salidas esperadas, pudiendo ya colaborar mediante tmic sobre los modelos pendientes del panel de cobertura.