Sentence Transformers comprime 4× los embeddings multivectoriales y retiene el 97,8 % de precisión con token pooling
Hugging Face detalla el entrenamiento consciente de pooling en Sentence Transformers para comprimir vectores 4× y retener el 97,8 % en NanoBEIR.
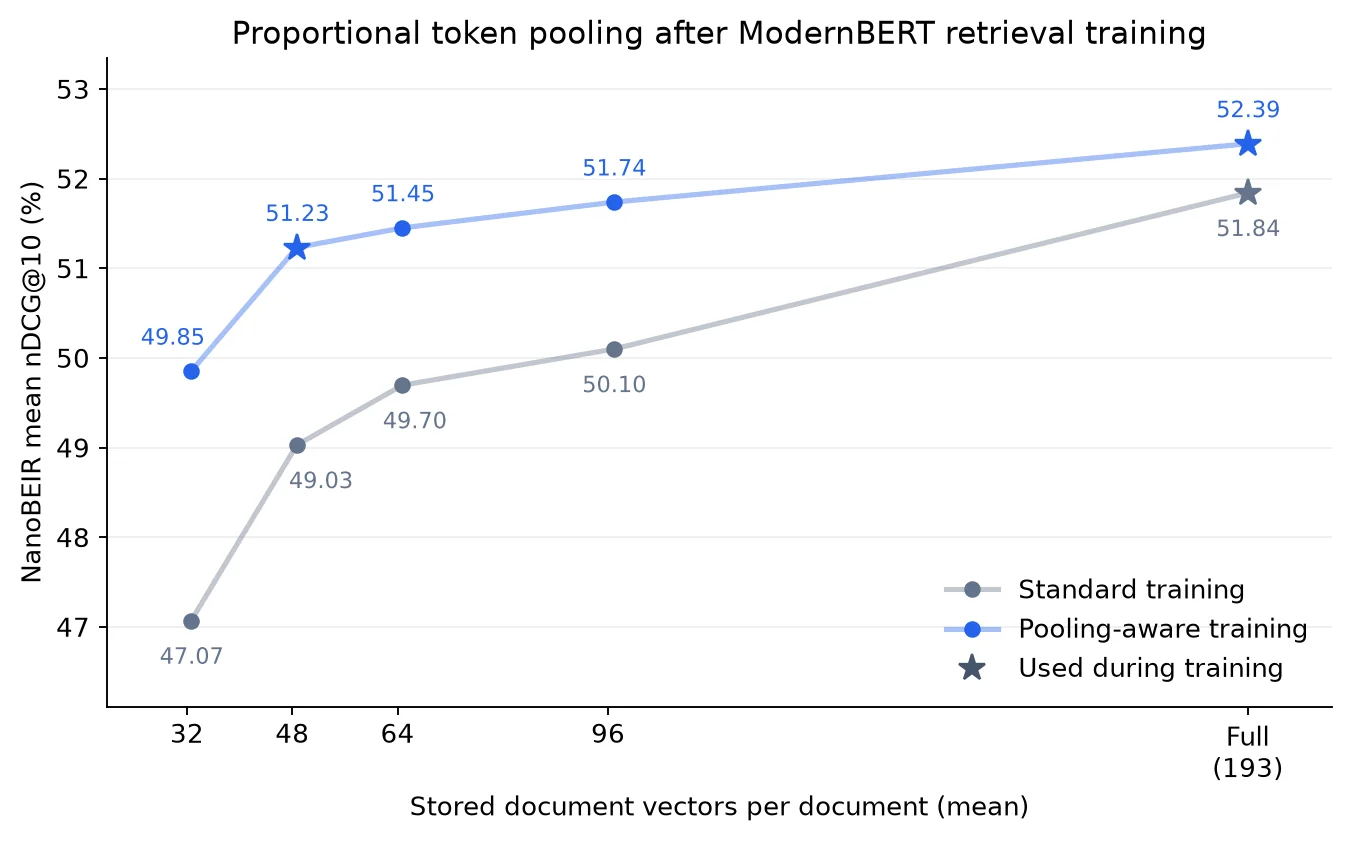
Los modelos de embeddings multivectoriales (multi-vector), como ColBERT, permiten que cada token de una consulta encuentre su propia coincidencia contextual dentro de un documento. Aunque esta arquitectura de late interaction supera en expresividad a los vectores únicos, dispara el almacenamiento hasta cientos de millones de vectores en corpus con millones de documentos.
Para resolver ese cuello de botella sin sacrificar precisión, el ingeniero de aprendizaje automático Tom Aarsen detalla en Hugging Face cómo aplicar entrenamiento consciente de pooling (token pooling-aware training) en Sentence Transformers. Con un factor de reducción de 4×, este enfoque eleva la retención en NanoBEIR del 94,6 % al 97,8 % bajo el mismo presupuesto de memoria.
La propuesta se apoya en el trabajo Learn to Pool de Stefan Josef (PDF), en el método previo de token pooling de Clavié, Chaffin y Adams (HF Papers 2409.14683) y en el estudio de regularización de LightOn. A diferencia de comprimir únicamente tras el entrenamiento, esta técnica enseña al codificador a reorganizar sus representaciones para resistir la fusión de vectores.
Por qué la recuperación multivectorial exige tantos vectores
Mientras un codificador convencional condensa todo un texto en un único vector, los modelos multivectoriales conservan una colección de vectores contextuales por token. Así, una búsqueda sobre un portátil con gran autonomía puede emparejar el término del equipo en una sección del documento y la duración de la batería en otra distinta.
El cálculo de relevancia emplea la función MaxSim, formulada como MaxSim(Q, D) = ∑_{q ∈ Q} max_{d ∈ D} qᵀ d. Cada vector de la consulta (q) selecciona el vector del documento (d) con mayor similitud y suma esas puntuaciones máximas para ordenar los resultados.
Incluso aplicando cuantización residual de 2 o 4 bits mediante herramientas como Fast-PLAID, el coste crece rápido a gran escala. A 4 bits por coordenada, almacenar 200 vectores de 128 dimensiones consume 12,8 KB por documento, o 12,8 GB por cada 1 millón de documentos. Reducir cada registro a 50 vectores recorta ese espacio hasta 3,2 GB manteniendo la misma dimensión y precisión.
Cómo agrupa vectores HierarchicalTokenPooling
Muchos tokens dentro de un mismo pasaje expresan conceptos cercanos y generan vectores redundantes. El módulo HierarchicalTokenPooling de Sentence Transformers aprovecha esta propiedad mediante agrupamiento jerárquico de Ward (Ward hierarchical clustering) para fusionar representaciones similares.
El algoritmo parte de un grupo por vector y une iterativamente el par que provoca el menor incremento en la dispersión interna, medida como suma de distancias cuadradas respecto a la media del grupo. Luego representa cada clúster mediante su promedio y renormaliza los vectores resultantes antes de evaluarlos con MaxSim.
De forma predeterminada, el módulo protege el primer token frente a fusiones y comprime únicamente los embeddings de documentos, dejando intactas las consultas. Para adaptar la compresión a cada caso de uso, HierarchicalTokenPooling ofrece tres parámetros alternativos de presupuesto:
| Parámetro | Comportamiento de compresión | Aplicación principal |
|---|---|---|
max_tokens=16 | Fija un máximo de 16 vectores por documento, incluidos los protegidos. | Índices con tope estricto de memoria por documento. |
pool_factor=4 | Conserva aproximadamente una cuarta parte de los vectores originales. | Compresión proporcional a la longitud del texto. |
distance_threshold=... | Aplica un umbral compartido de distancia de fusión de Ward. | Ajuste adaptativo según la geometría semántica. |
Esta diferencia cobra relevancia cuando la longitud de los documentos varía dentro del índice. Mientras la reducción proporcional conserva más capacidad en textos largos, el modo por umbral permite ampliar el conteo de vectores cuando existen más embeddings diferenciados que preservar.
El pooling adaptativo funciona incluso sobre modelos entrenados sin un objetivo consciente de compresión, como lightonai/LateOn. Al invocar HierarchicalTokenPooling.calibrate_distance_threshold(calibration_embeddings, target_tokens=16) sobre una muestra representativa, se obtiene un umbral reutilizable durante la indexación con model.encode_document(documents_to_index, token_pooling=pooling).
No obstante, target_tokens define únicamente un promedio objetivo sobre la muestra de calibración. En producción, cada documento individual puede recibir más o menos de 16 vectores, y el promedio alcanzado puede variar al cambiar de corpus.
Entrenamiento consciente de pooling con MultiVectorTokenPoolingLoss
Comprimir un modelo multivectorial ordinario funciona hasta cierto punto, pero la precisión cae cuando la fusión oculta distinciones que el codificador nunca necesitó preservar. El entrenamiento consciente de pooling aplica un principio cercano al de los embeddings Matryoshka: en lugar de entrenar sobre distintas anchuras vectoriales, optimiza el retrieval sobre representaciones con menos tokens.
En el esquema propuesto, cada batch combina de forma equitativa dos pérdidas bajo la relación L = 0,5 · L_unpooled + 0,5 · L_pooled. El primer término enseña al modelo a recuperar con la representación completa y el segundo lo entrena para organizar sus embeddings de modo que las coincidencias útiles sobrevivan a una compresión de un cuarto.
Como el agrupamiento de Ward adopta decisiones discretas, HierarchicalTokenPooling emplea durante el entrenamiento un straight-through estimator. Este mecanismo propaga los gradientes desde los vectores agrupados de vuelta hacia los tokens integrantes sin necesidad de diferenciar las asignaciones de clúster.
En Sentence Transformers, MultiVectorTokenPoolingLoss envuelve una pérdida base como CachedMultiVectorMultipleNegativesRankingLoss, que aprovecha caché de gradientes (HF Papers 2101.06983) para procesar mini-batches de 64 ejemplos dentro de un batch de 256 utilizando model.similarity ("maxsim" o "meanmaxsim").
Al configurar token_poolings=[None, pooling] y weights=[0.5, 0.5], tanto la variante original como la comprimida reutilizan los embeddings ya calculados por el codificador. Así, añadir nuevos poolers —incluidas subclases personalizadas de BaseTokenPooling que conserven gradientes— solo suma coste de agrupamiento y puntuación sin repetir el forward pass.
El repositorio oficial publica el script completo training_cached_contrastive.py, ejecutable en local con uv run (usando --baseline para el modelo ordinario) o en la nube con Hugging Face Jobs mediante hf jobs uv run --flavor a10g-small --timeout 4h --secrets HF_TOKEN en una GPU A10G.
Aceleración por kernels CUDA e inferencia práctica
Tanto el entrenamiento como la inferencia admiten aceleración instalando pip install -U "sentence-transformers[train,kernels]" y pasando use_kernels=True al inicializar MultiVectorEncoder. Los módulos jerárquicos heredan esta configuración y recurren automáticamente a la implementación estándar cuando falta un kernel compatible.
El kernel predeterminado de MaxSim, que requiere CUDA y Triton, evalúa consultas frente a documentos sin materializar en memoria la matriz completa de similitud entre tokens. A su vez, el kernel de agrupamiento de Ward ejecuta el algoritmo sobre CUDA en lugar de la CPU y alcanza aceleraciones de entre 30× y 150× respecto a SciPy según la configuración.
Debido a que use_kernels=True no se almacena dentro de los pesos guardados, conviene reactivarlo al cargar checkpoints como tomaarsen/mve-ModernBERT-base-token-pooling. En la demostración sobre tres textos cortos con pool_factor=4, los vectores de documento bajan de 58 ([18, 21, 19]) a 16 ([5, 6, 5]) manteniendo intactas las consultas y el orden del ranking.
Frente a la consulta sobre qué planeta se conoce como el Planeta Rojo, Marte conserva la mayor similitud (25,9879 frente a 27,6060 sin comprimir), por delante de Júpiter (22,8159) y Venus (16,0037). Además, el usuario puede cambiar pool_factor en inferencia o definir token_pooling=pooling al instanciar MultiVectorEncoder para aplicarlo por defecto únicamente a documentos.
Resultados de evaluación en NanoBEIR@13
Para aislar el impacto de la función de pérdida, Aarsen entrenó dos modelos a partir de answerdotai/ModernBERT-base con una proyección nueva de 128 dimensiones: el modelo ordinario tomaarsen/mve-ModernBERT-base-token-pooling-baseline y la variante consciente de pooling. Ambos utilizaron 120.000 tripletas de MS MARCO durante una época con semilla 42 y sin búsqueda de hiperparámetros.
El entrenamiento limitó los documentos a 300 tokens y expandió las consultas cortas a un mínimo de 32 posiciones para dotarlas de mayor capacidad contextual. Posteriormente, ambos codificadores se evaluaron en NanoBEIR@13 midiendo el nDCG@10 (%) promedio en cinco regímenes distintos de compresión.
Los ensayos confirman que el entrenamiento consciente de pooling supera al enfoque ordinario en todas las configuraciones evaluadas, incluida la recuperación sin comprimir. Con el parámetro entrenado (pool_factor=4), reduce un 74,8 % los vectores almacenados frente al índice completo y eleva la retención del 94,6 % al 97,8 %.
Las mejoras también se transfieren a límites fijos y umbrales adaptativos nunca vistos durante el entrenamiento. Con un promedio de 29,58 vectores por documento bajo pooling adaptativo, el modelo consciente de compresión retiene el 97,3 % de su puntuación original ahorrando un 84,7 % de vectores, frente al 93,3 % de retención del modelo ordinario.
| Configuración en inferencia | Vectores medios | Modelo ordinario | Modelo pooling-aware | Ganancia (puntos) |
|---|---|---|---|---|
| Sin pooling | 193,22 | 51,84 | 52,39 | +0,55 |
pool_factor=2 | 96,86 | 50,10 | 51,74 | +1,64 |
pool_factor=3 | 64,74 | 49,70 | 51,45 | +1,76 |
pool_factor=4 | 48,68 | 49,03 | 51,23 | +2,20 |
pool_factor=5 | 39,04 | 48,13 | 50,28 | +2,15 |
pool_factor=6 | 32,62 | 47,07 | 49,85 | +2,78 |
max_tokens=64 | 54,76 | 49,27 | 50,89 | +1,63 |
max_tokens=32 | 29,58 | 48,25 | 50,12 | +1,87 |
max_tokens=16 | 15,60 | 46,61 | 49,26 | +2,65 |
max_tokens=8 | 7,99 | 43,12 | 46,61 | +3,48 |
max_tokens=4 | 4,00 | 37,22 | 43,00 | +5,78 |
distance_threshold (calibrado) | 54,76 | 50,10 | 51,24 | +1,14 |
distance_threshold (calibrado) | 29,58 | 48,38 | 50,96 | +2,58 |
distance_threshold (calibrado) | 15,60 | 47,23 | 49,63 | +2,41 |
En el régimen adaptativo con distance_threshold, se calibró un umbral específico para cada codificador y colección de NanoBEIR buscando igualar el volumen medio de vectores de los topes 64, 32 y 16. La presencia de textos cortos sitúa las medias reales ligeramente por debajo de esos límites.
Cómo combinar técnicas de compresión en producción
Cuando reducir el tamaño del índice resulta prioritario, el análisis aconseja aplicar tres técnicas en orden secuencial. En primer lugar, recurrir a cuantización de embeddings a 4, 2 o 1 bit —por ejemplo, mediante Fast-PLAID— para disminuir el almacenamiento por coordenada.
El segundo paso consiste en recortar la cantidad de vectores por documento con token pooling, complementado opcionalmente con ajuste fino consciente de pooling. En tercer lugar, los embeddings Matryoshka permiten reducir la dimensionalidad de cada vector, un paso que conviene priorizar antes si la dimensión base del modelo supera 128.
Estas capas pueden entrenarse de forma conjunta envolviendo MultiVectorMatryoshkaLoss dentro de MultiVectorTokenPoolingLoss para optimizar simultáneamente menos vectores y menor anchura reutilizando los mismos embeddings. Para medir este compromiso entre calidad y memoria en cualquier modelo propio, el repositorio incluye el script de evaluación evaluate_token_pooling.py.
Fuente: Token Pooling-Aware Training for Multi-Vector Embedding Models