Reson8 libera Rumble-2-Flash, un modelo abierto de voz de 500 millones de parámetros
Reson8 publica Rumble-2-Flash bajo licencia Apache 2.0: un modelo ASR de 500 millones de parámetros compatible con más de 40 idiomas y 7.000 RTFx.
La compañía Reson8 liberó Rumble-2-Flash bajo licencia Apache 2.0, un modelo de reconocimiento automático del habla (ASR) de 500 millones de parámetros diseñado para operar en más de 40 idiomas. El lanzamiento, detallado en el blog oficial de Hugging Face, posiciona a este sistema compacto frente a arquitecturas entre 3 y 60 veces más grandes.
El modelo integra detección automática de idioma y ofrece soporte nativo en las bibliotecas Transformers y vLLM sin requerir código personalizado. Además, permite controlar el formato de salida para representar números en dígitos o palabras, gestionar muletillas, conservar repeticiones literales o forzar un idioma específico.
Arquitectura y destilación on-policy con GOLD
Rumble-2-Flash adopta la arquitectura Qwen3-ASR para garantizar compatibilidad inmediata en entornos de producción que ya ejecutan Transformers o vLLM, prescindiendo de bifurcaciones de runtime o del parámetro trust_remote_code. Para reducir su tamaño sin sacrificar precisión, el equipo de ingeniería destiló su modelo de producción de mayor escala, Rumble-2, mediante un proceso de destilación on-policy.
A diferencia del entrenamiento convencional con transcripciones estáticas del modelo profesor, el modelo estudiante genera sus propias transcripciones y el profesor las evalúa token a token. En cada posición de la secuencia, el profesor asigna su probabilidad esperada, permitiendo que el estudiante corrija de forma granular los errores que comete durante la inferencia.
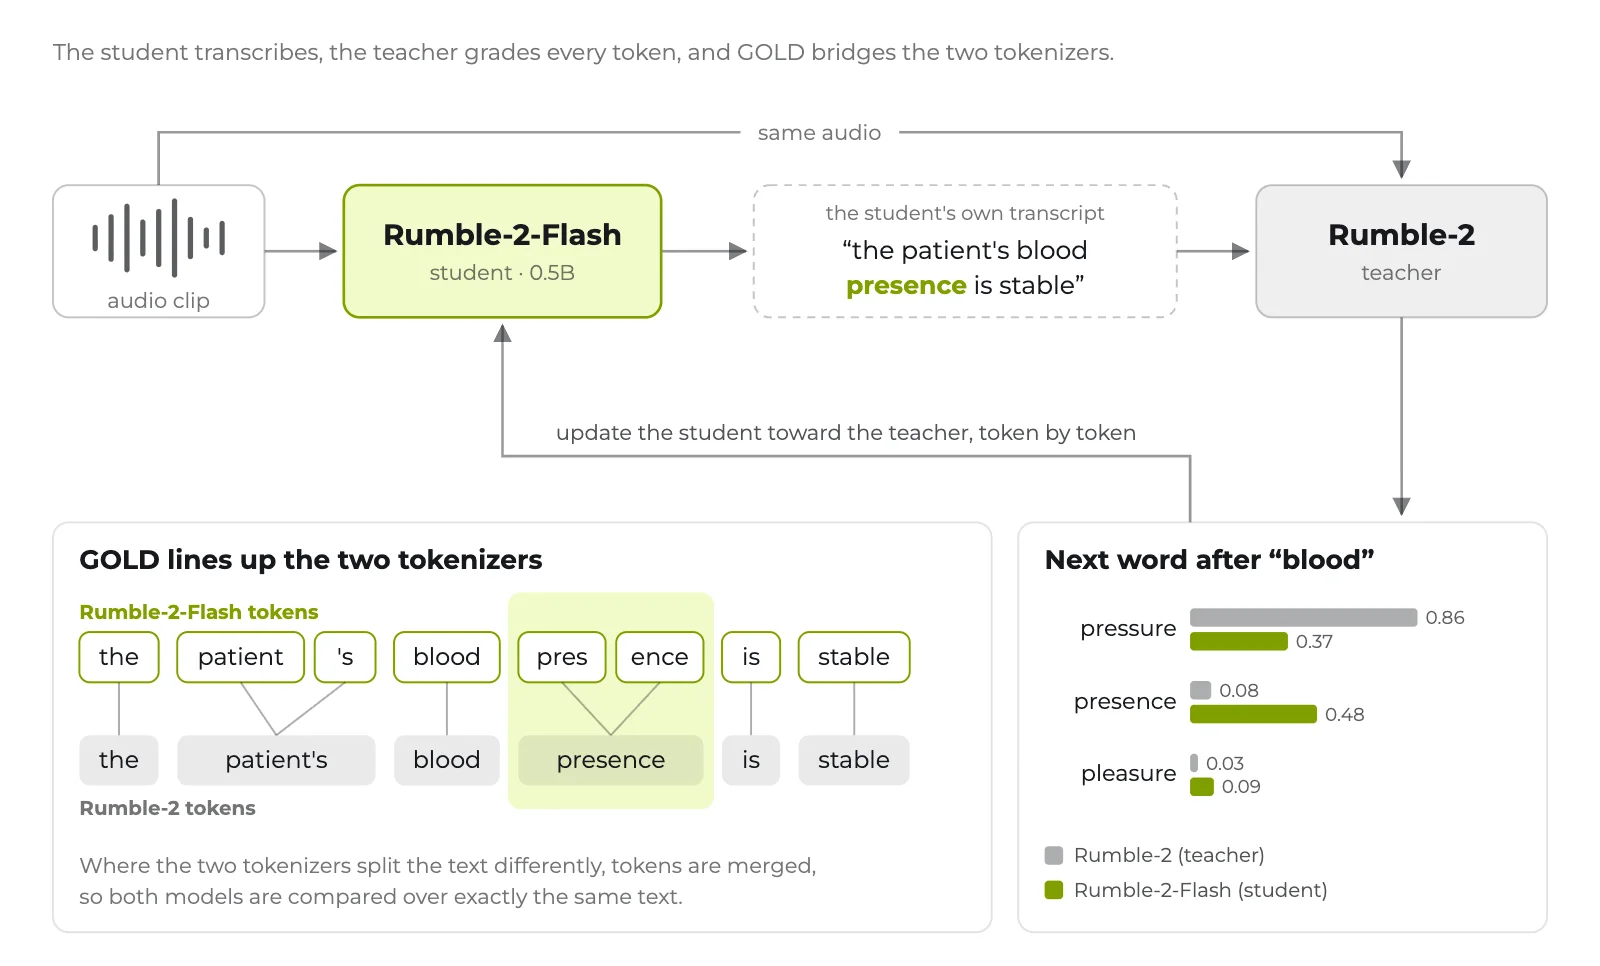
Dado que la adopción de Qwen3-ASR implicaba utilizar su vocabulario propio —distinto al del modelo profesor—, el equipo empleó la técnica GOLD (Generalized On-Policy Logit Distillation). Este método fusiona tokens cuando ambos tokenizadores segmentan el texto de manera diferente, comparando directamente los tokens compartidos y alineando el resto mediante sus probabilidades ordenadas.
Precisión multilingüe y velocidad de procesamiento
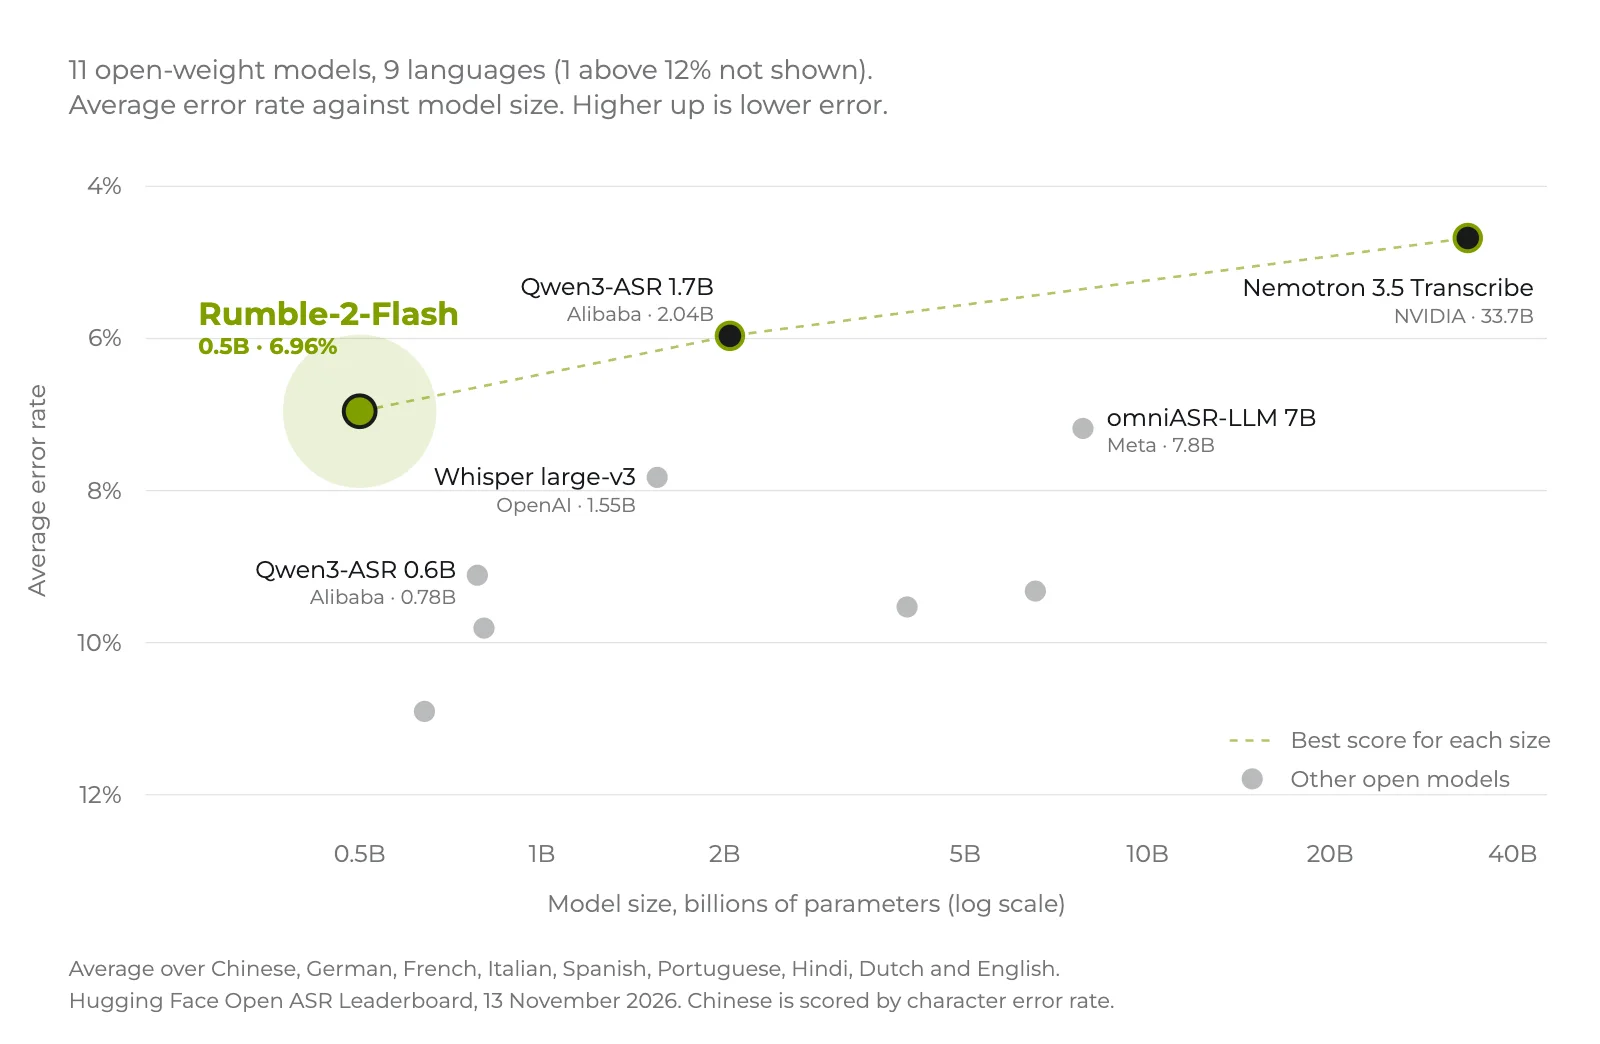
En la pista multilingüe del Open ASR Leaderboard, Rumble-2-Flash registra una tasa de error promedio del 6,96 % en nueve idiomas: chino, alemán, francés, italiano, español, portugués, hindi, neerlandés e inglés. Con esta marca, el modelo de 500 millones de parámetros supera a omniASR-LLM 7B de Meta (15 veces mayor) y a Whisper large-v3, mientras que en la pista exclusiva en inglés alcanza un promedio de 6,6 % de tasa de error por palabra (WER).
En cuanto al rendimiento computacional, el volumen de procesamiento depende del nivel de llenado de los lotes (batches). En los conjuntos de datos más extensos de la clasificación de Hugging Face, donde los lotes se mantienen completos, Rumble-2-Flash supera los 7.000 RTFx, lo que equivale a transcribir una hora de audio en aproximadamente medio segundo.
Desempeño en llamadas telefónicas reales
El audio limpio de estudio suele ofrecer métricas favorables, pero las conversaciones telefónicas presentan compresión, ruido de fondo y una amplia diversidad de acentos. Para evaluar este escenario, Reson8 probó el modelo en el benchmark de centros de llamadas de AppTek, compuesto por 302 horas de grabaciones de líneas de asistencia en 14 acentos distintos del inglés.
| Modelo | Parámetros | WER en AppTek |
|---|---|---|
| Qwen3-ASR 1.7B | 1.700 millones | 7,40 % |
| NVIDIA Nemotron 3.5 Transcribe | 30.000 millones | 7,78 % |
| Rumble-2-Flash | 500 millones | 7,86 % |
| Qwen3-ASR 0.6B | 600 millones | 8,70 % |
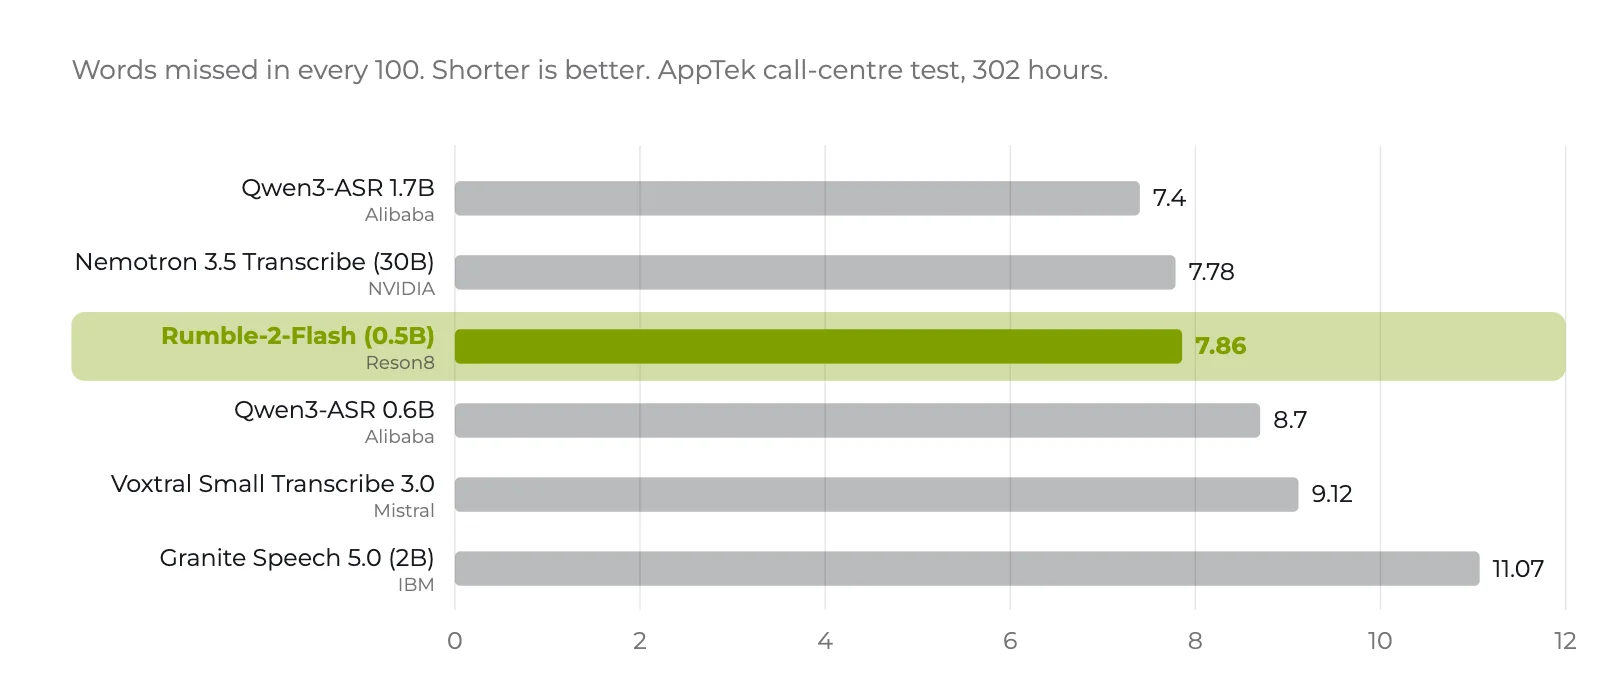
Los resultados muestran que Rumble-2-Flash logra una paridad técnica frente a Nemotron 3.5 Transcribe de NVIDIA —un modelo de 30.000 millones de parámetros— y supera claramente a Qwen3-ASR 0.6B dentro de su misma familia arquitectónica. Los pesos abiertos del modelo ya se encuentran disponibles en el repositorio Reson8/Rumble-2-Flash, además de ofrecerse mediante la interfaz de programación (API) comercial de la compañía.
Fuente: Hugging Face