Alibaba lanza Qwen4-Max con arquitectura híbrida para competir con Opus 5.5, GPT-6 y Kimi K3.1 Pro a menor coste
Alibaba presenta Qwen4-Max, un modelo MoE de 2,4 billones de parámetros que reduce costes por tarea y compite con Opus 5.5, GPT-6 y Kimi K3.1 Pro.
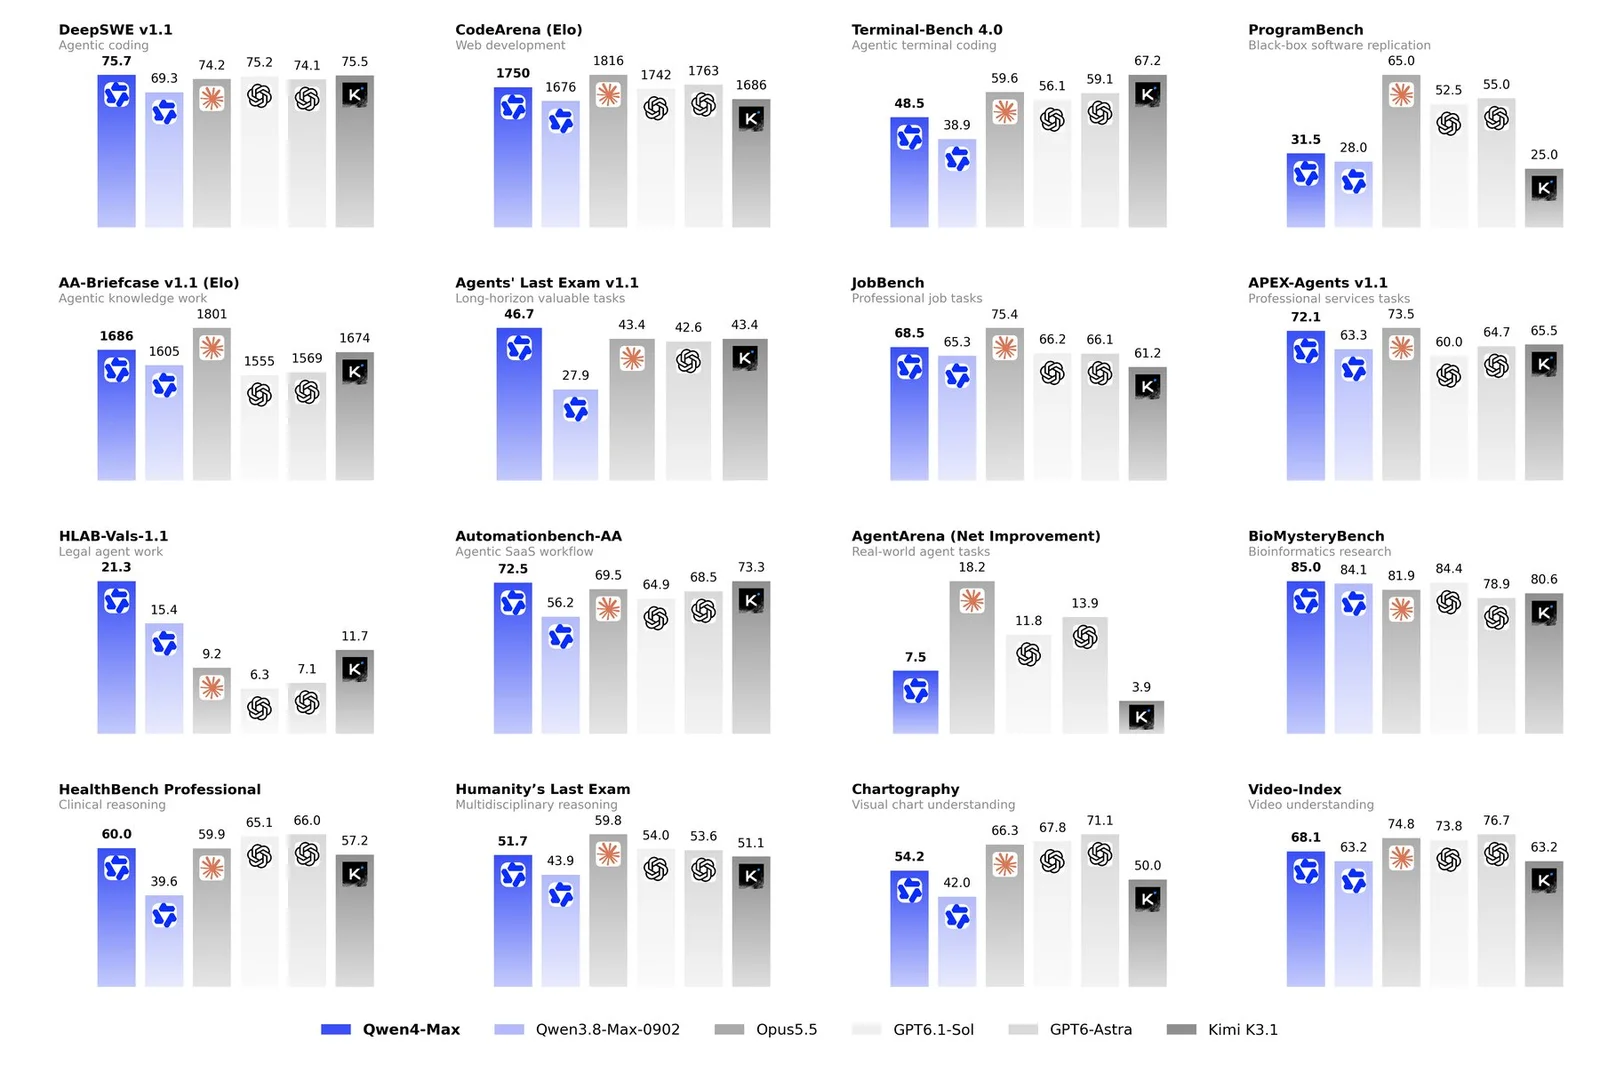
Alibaba ha presentado Qwen4-Max, su nuevo modelo insignia de inteligencia artificial diseñado para competir directamente con Claude Opus 5.5, GPT-6 y Kimi K3.1 Pro en entornos profesionales de industria, ciencia y finanzas. Según informa The Decoder a partir de la documentación publicada en el blog oficial de Qwen, el lanzamiento combina una arquitectura renovada con tarifas por tarea significativamente más bajas.
El modelo emplea un diseño mixture-of-experts (MoE) de 2,4 billones de parámetros totales, aunque activa únicamente 71.000 millones por cada token procesado. Además, procesa imágenes de forma nativa y ofrece una ventana de contexto de un millón de tokens.
Arquitectura híbrida para contextos extensos
Qwen4-Max estrena la arquitectura de la serie Qwen4 al combinar dos mecanismos distintos en lugar de depender exclusivamente de capas de atención estándar. Tres capas comprimen el contexto previo en un estado condensado y una cuarta capa selecciona únicamente los fragmentos relevantes, lo que reduce drásticamente el cómputo en entradas extensas.
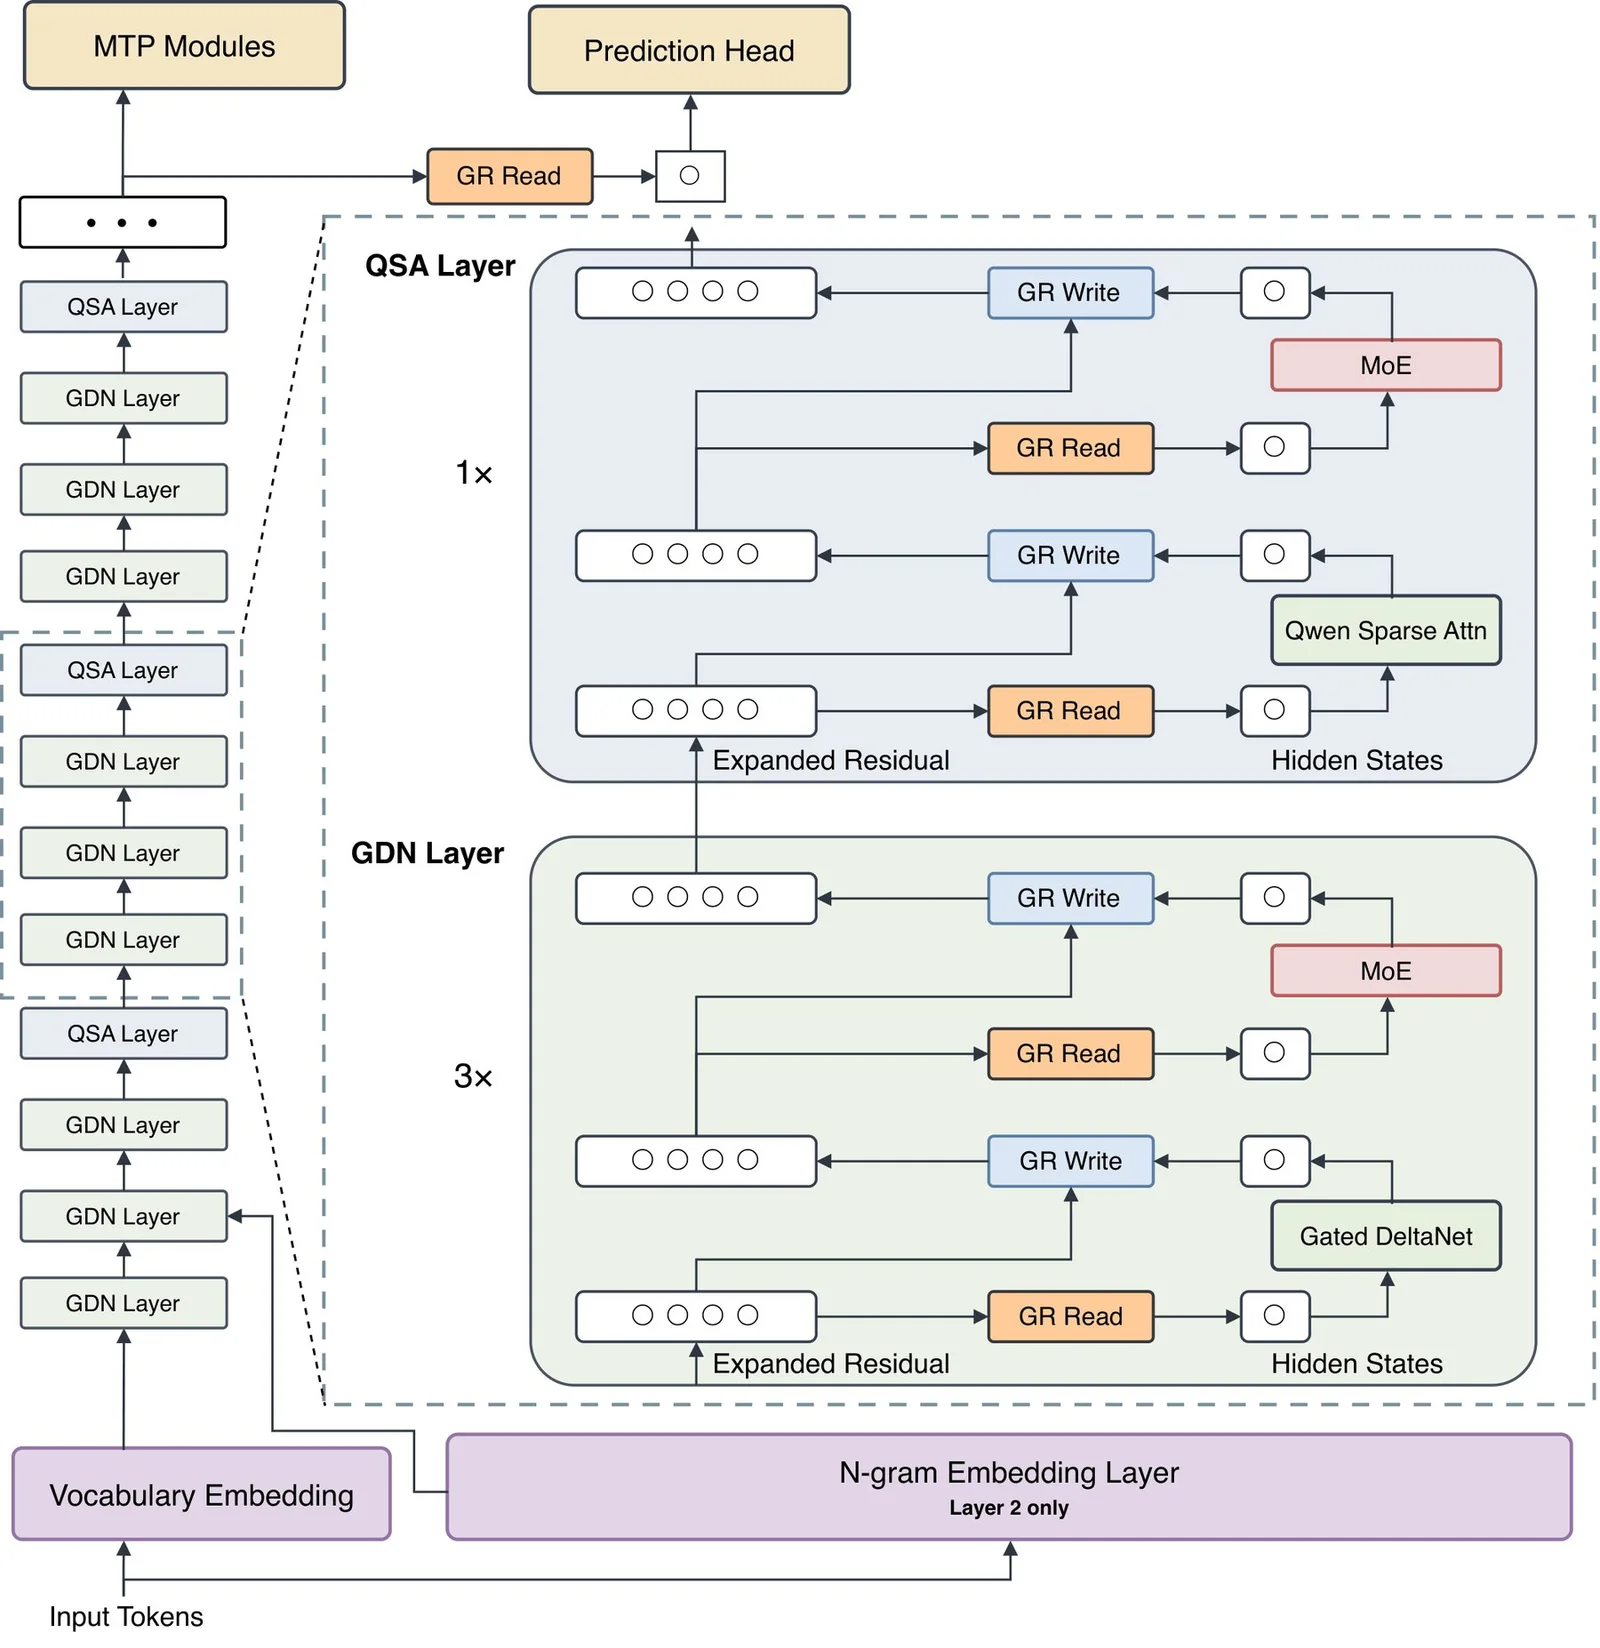
El diseño incorpora cuatro conexiones paralelas entre capas con puertas dinámicas para estabilizar el flujo de información. También integra una capa de incrustación N-grama con 328.000 millones de parámetros que suministra secuencias frecuentes como bloques preconstruidos.
Alibaba señala que el entrenamiento de esta configuración transcurrió con estabilidad y sin picos repentinos de pérdida. En sus evaluaciones internas medidas en bits por byte sobre conocimiento, código, respuesta a preguntas y disciplinas STEM, la variante base Qwen4-Max-Base superó entre un 5 % y un 13 % a Qwen3.8-Max-Base activando un 25 % menos de parámetros por token.
Eficiencia de tokens y costes por tarea
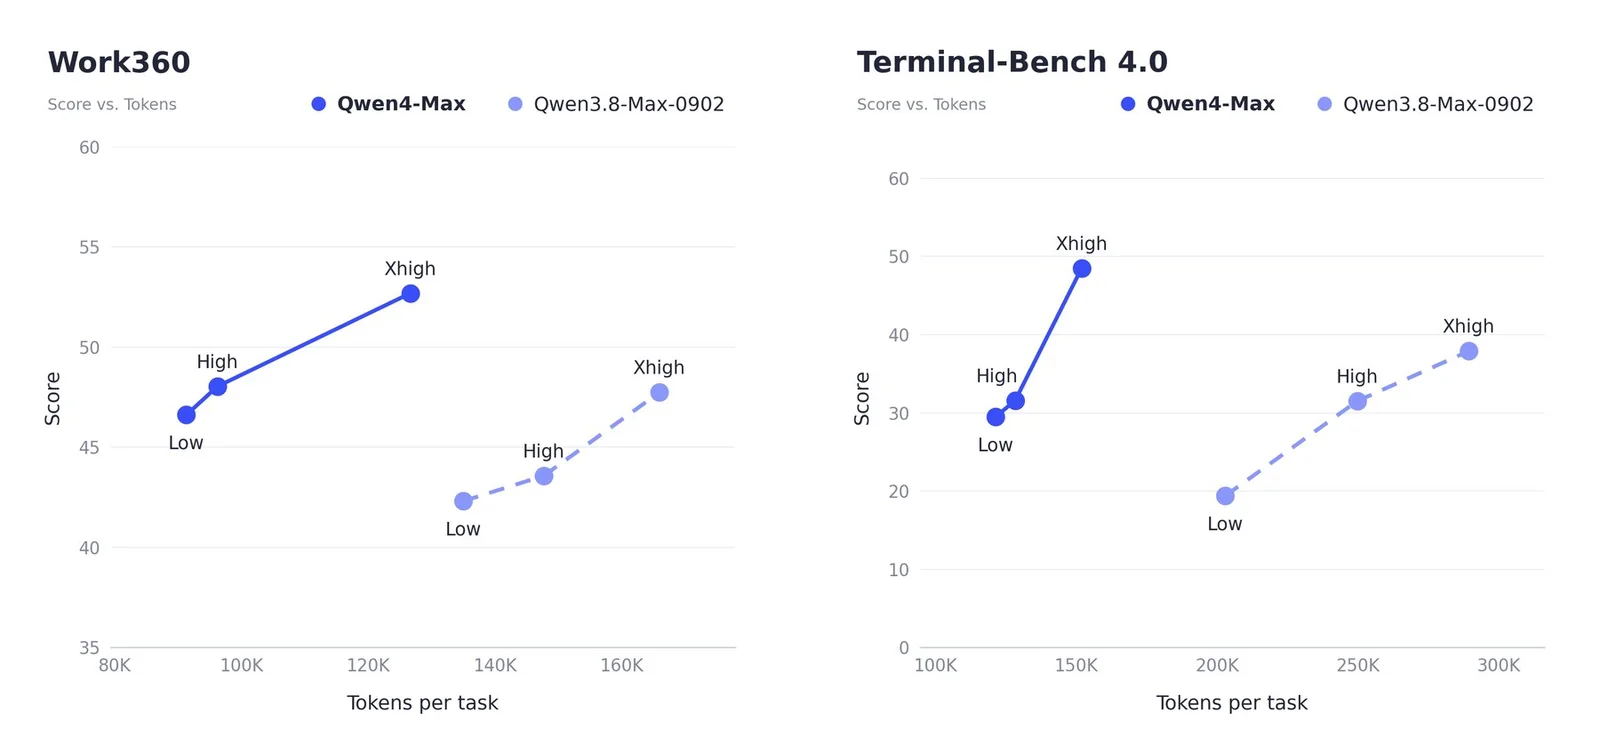
Las mejoras arquitectónicas se traducen en un menor consumo de cómputo durante la ejecución. En Work360, la evaluación interna de Alibaba para tareas industriales en 721 campos especializados, Qwen4-Max utiliza entre un cuarto y un tercio menos de tokens que su predecesor, elevando la puntuación de 47,74 a 52,69 puntos y reduciendo el coste medio por tarea un 62 %, desde 4,43 dólares hasta 1,67 dólares.
En evaluaciones externas, el desempeño varía según el dominio. Qwen4-Max lidera el grupo comparativo en tareas agénticas de largo horizonte como Agents’ Last Exam v1.1 con 46,7 puntos, supera por poco a Opus 5.5 en HealthBench Professional —aunque queda por detrás de los modelos GPT— y se sitúa tras Opus 5.5 y la familia GPT en Humanity’s Last Exam.
Posición en Artificial Analysis y precios de API
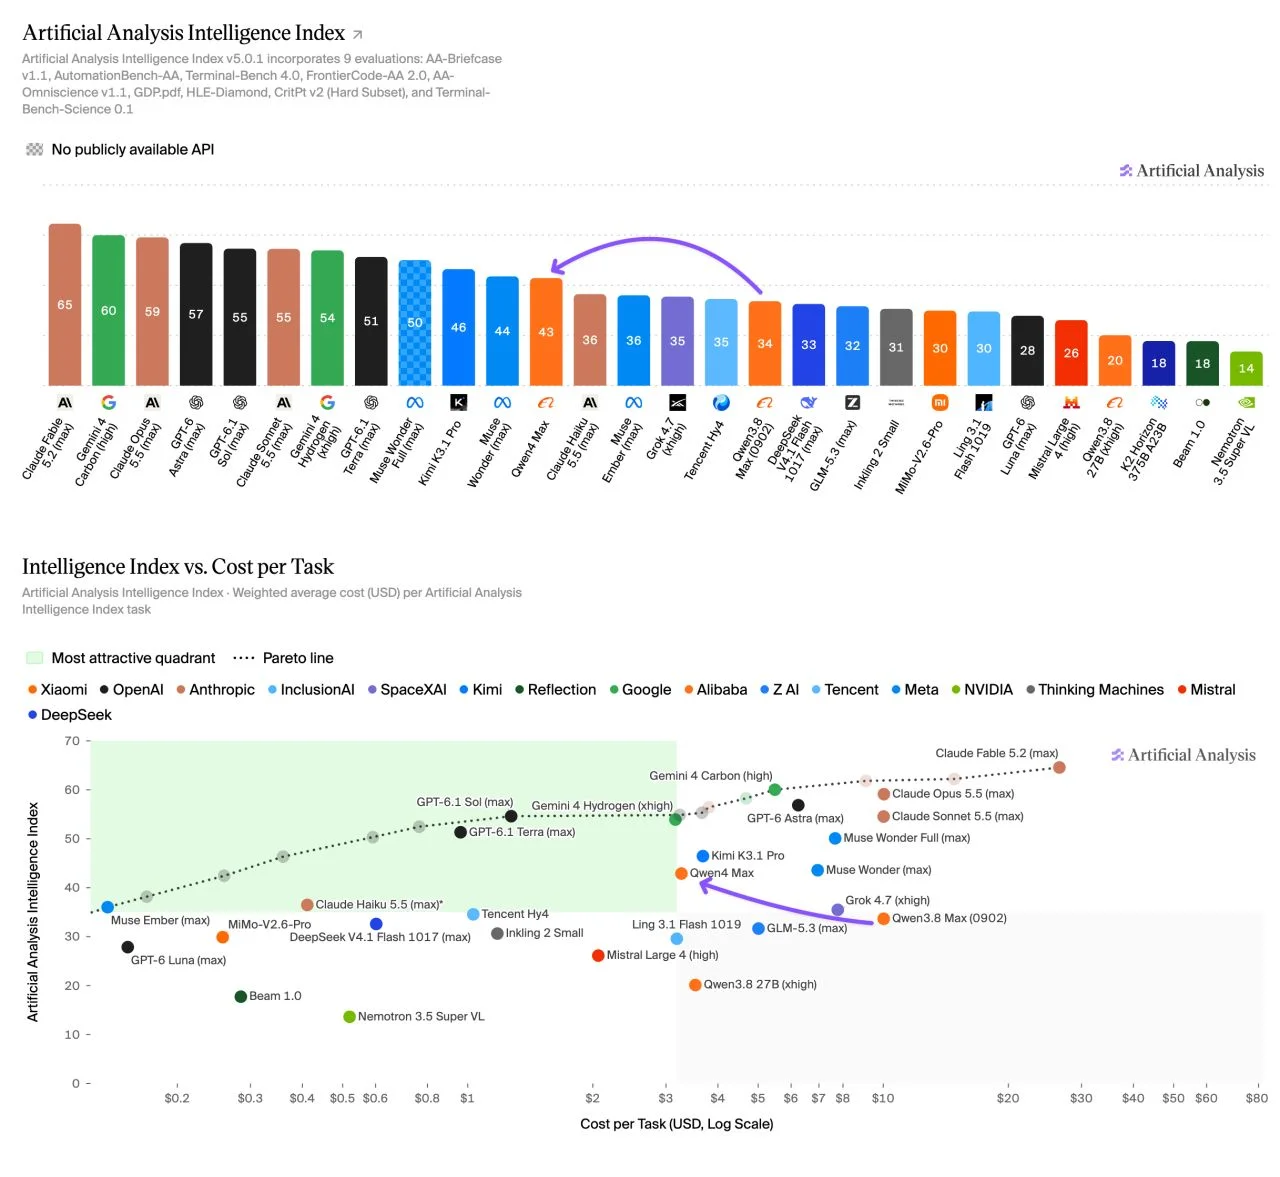
En su nivel máximo de razonamiento, el modelo alcanza el segundo puesto entre los sistemas chinos en el Artificial Analysis Intelligence Index v5.0.1, logrando un ahorro sustancial frente a la generación anterior gracias a tarifas un 25 % inferiores, un descuento del 70 % en cache hits y una reducción de 171.000 a unos 105.000 tokens de salida por tarea.
| Modelo | Intelligence Index v5.0.1 | Coste por tarea (USD) | Terminal-Bench 4.0 | FrontierCode 2.0 |
|---|---|---|---|---|
| Qwen4-Max | 43 puntos | 3,27 dólares | 48 % | 26 % |
| Qwen3.8-Max | 34 puntos | 10,02 dólares | — | — |
| Kimi K3.1 Pro | 46 puntos | 3,68 dólares | 67 % | 26 % |
| Tencent Hy4 | 35 puntos | 1,03 dólares | — | 31 % |
Los mayores avances de Qwen4-Max frente a su antecesor en este índice se registran en HLE-Diamond, donde sube 21 puntos hasta el 45 %, junto a mejoras de 18 puntos en AA-Omniscience y 17 en AutomationBench-AA. A través de su propia API, Alibaba fija un precio de 1,50 dólares por millón de tokens de entrada, 4,50 dólares por millón de tokens de salida y 0,075 dólares para cache hits.
«Live Delivery» y despliegues en industria y nube
Para evitar que los usuarios tengan que esperar al final de procesos agénticos largos para detectar errores, Alibaba introduce la función «Live Delivery». El sistema entrega una primera versión funcional de forma temprana y la refina en pasadas posteriores, permitiendo intervenir sobre la marcha mediante el complemento Qwen-Live-Delivery-Plugin, publicado como open source.
En entornos industriales y financieros, la compañía detalla varios casos de uso concretos:
- Automoción: Los socios SANF y Pacific Union redujeron el tiempo de programación manual de una pieza de unos 475 minutos a 24 minutos.
- Finanzas: El modelo se conecta a 90 herramientas MCP para recopilar datos de mercado y generar archivos Excel y PowerPoint verificables con trazabilidad de cada cifra.
- Infraestructura propia: Junto al optimizador interno MindOpt, recortó en un 10,42 % medio el coste de asignar trabajos de anotación de datos y resolvió la distribución de tareas de CPU en centros de datos más de 14 veces más rápido que el método de referencia.
Experimentación autónoma en laboratorios
La generación Qwen4 también opera en laboratorios físicos automatizados. En colaboración con el sistema Mira de la empresa emergente Deep Principle, el modelo trabajó de forma autónoma durante 48 horas para diseñar, sintetizar y probar un nuevo refrigerante para chips de centros de datos de alto rendimiento, evaluando 2,7 millones de candidatos moleculares en cuatro ciclos completos.
En el ámbito biomédico, Qwen4-Max colaboró con la plataforma PharmMaster, de la firma pekinesa DP Technology, para optimizar 24 moléculas candidatas contra una respuesta inflamatoria vinculada al alzhéimer. El compuesto final mostró una afinidad de unión a la proteína objetivo unas 3,6 veces superior al compuesto inicial patentado, un resultado que los especialistas de DP Technology consideran prometedor para continuar con ensayos de laboratorio.
Desarrollo de videojuegos desde un solo prompt
Alibaba muestra asimismo capacidades de creación de videojuegos integradas con motores como Unity, Unreal Engine y Godot. A partir de una única descripción en lenguaje natural, Qwen4-Max gestiona la configuración de escenas, la lógica de juego, la integración de recursos externos, materiales, interfaz y efectos visuales hasta obtener una versión jugable.
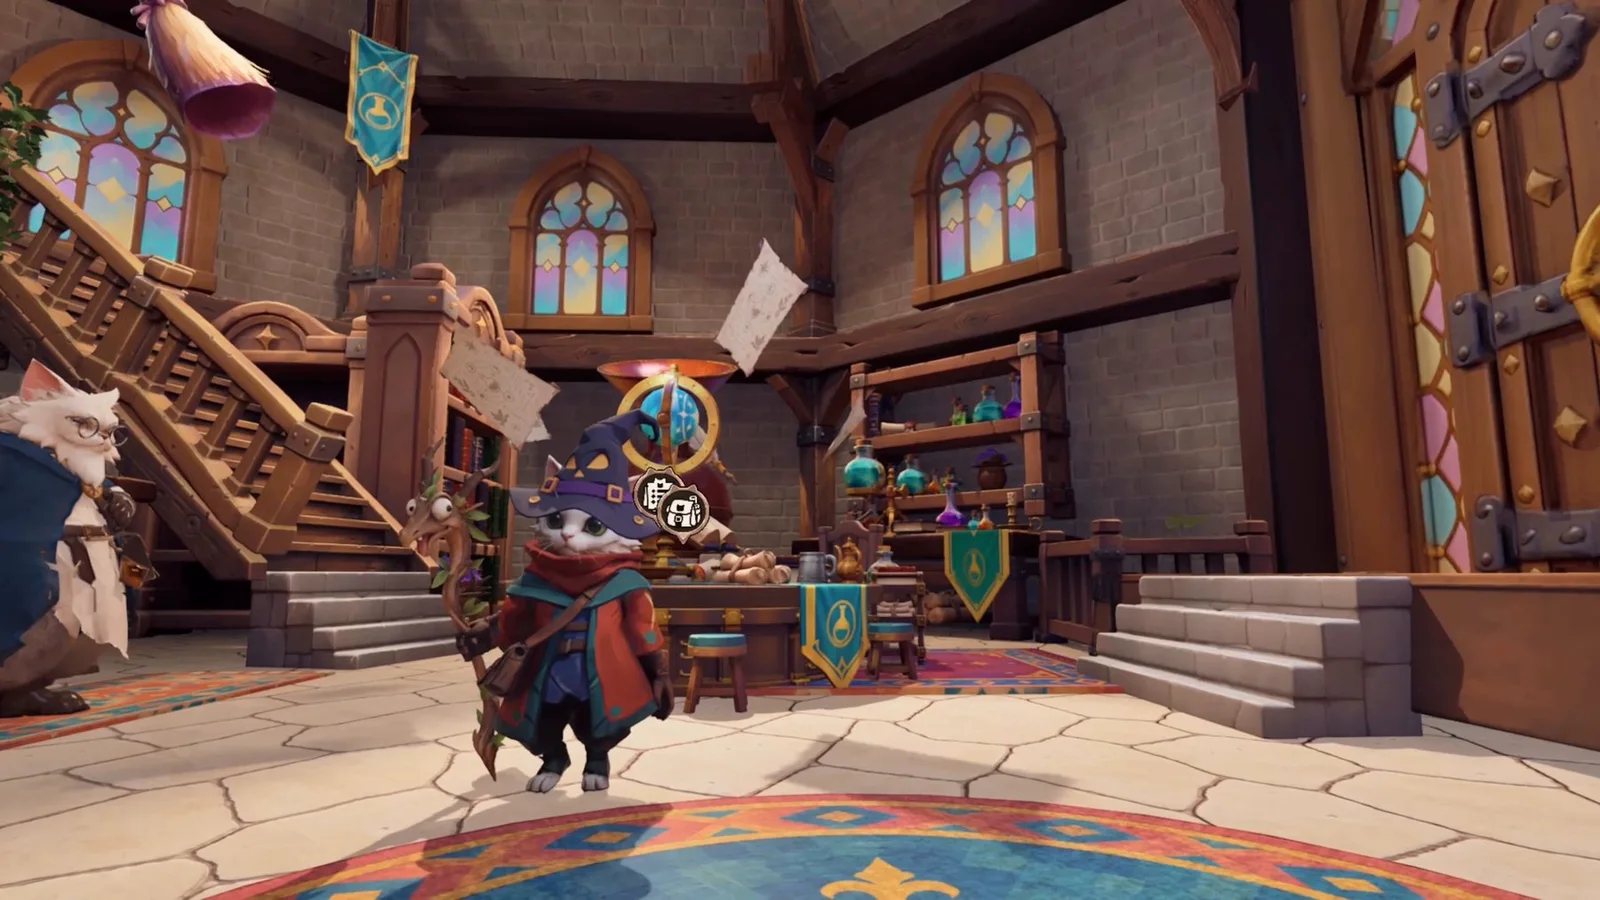
Durante el proceso, el modelo ejecuta el título y utiliza retroalimentación visual e interactiva para ajustar cámaras, animaciones, reacciones de impacto e iluminación, como en el proyecto de ejemplo «Meow of Magic» en Unreal Engine. También genera modelos 3D en Blender reutilizables para videojuegos o impresión 3D, un enfoque opuesto al de Anthropic, que recientemente restringió en Claude Code la recreación de títulos comerciales tras proliferar clones no oficiales.
Seguridad, disponibilidad y contexto competitivo
En la evaluación de seguridad Last Secure Code Bench, la proporción de código funcional y seguro aumentó del 22 % al 31,8 %, y el porcentaje calificado como seguro en los tres niveles de prueba casi se duplicó del 8 % al 14,7 %. En pruebas internas sobre riesgos QBRN (químicos, biológicos, radiológicos y nucleares), los revisores analizaron las cadenas de razonamiento completas del modelo y concluyeron que no aporta una capacidad de innovación que eleve significativamente el riesgo.
Qwen4-Max ya se encuentra disponible en QwenCloud, QwenWork, Qoder y QwenStudio, mientras que Alibaba prevé publicar más adelante variantes Qwen4 más pequeñas bajo licencia open source. A diferencia de Qwen3.8-Max —lanzado en agosto con 2,4 billones de parámetros y 95.000 millones activos por token cuyos pesos sí se abrieron—, los pesos de Qwen4-Max permanecen cerrados por ahora frente a competidores chinos como Kimi K3.1 Pro, DeepSeek V4-Pro y GLM-5.3.
Fuente: The Decoder