Meituan libera LongCat-2.5, un modelo agéntico de 1,6 billones de parámetros entrenado sin GPU de Nvidia
Meituan publica los pesos de LongCat-2.5 bajo licencia MIT: 1,6 billones de parámetros, enfoque multimodal agéntico y despliegue en chips Huawei Ascend.
El equipo LongCat de la compañía china de reparto de comida Meituan ha publicado los pesos de LongCat-2.5, un modelo de 1,6 billones de parámetros diseñado para agentes autónomos de inteligencia artificial y entrenado íntegramente con hardware chino. Según recoge The Decoder, la liberación se produce una semana después de su presentación oficial.
LongCat-2.5 está orientado a agentes que ejecutan tareas largas de múltiples pasos de forma autónoma, con especial énfasis en la programación. De acuerdo con los datos de Meituan, su rendimiento en pruebas de código se sitúa cerca del nivel que alcanzaron modelos estadounidenses como Claude Opus 5 hace unos meses.
Arquitectura MoE, ventana de contexto y tokenización visual
El modelo utiliza una arquitectura mixture-of-experts (MoE) que activa solo un subconjunto de sus subredes especializadas por cada token procesado. De sus 1,6 billones de parámetros totales, alrededor de 48.000 millones permanecen activos por token. A través de la API, admite entradas de hasta un millón de tokens y genera respuestas de hasta 128.000 tokens, con soporte para texto, imagen y vídeo, respuesta en texto y activación opcional del modo de razonamiento.
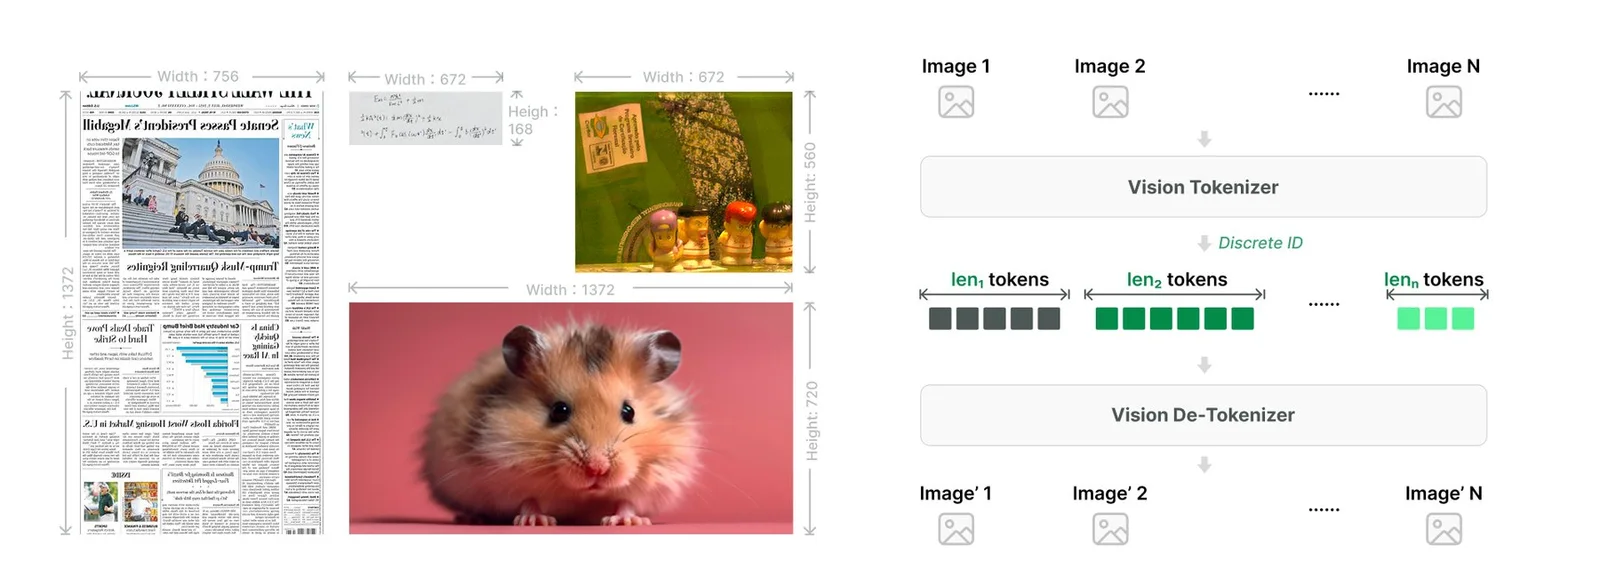
LongCat-2.5 parte de su predecesor LongCat-2.0 e incorpora comprensión visual nativa. En lugar de acoplar un codificador de imágenes separado a posteriori, convierte las imágenes en tokens discretos que procesa junto al texto, siguiendo el enfoque del modelo de investigación LongCat-Next para mejorar tareas de programación visual, diseño y entornos 3D.
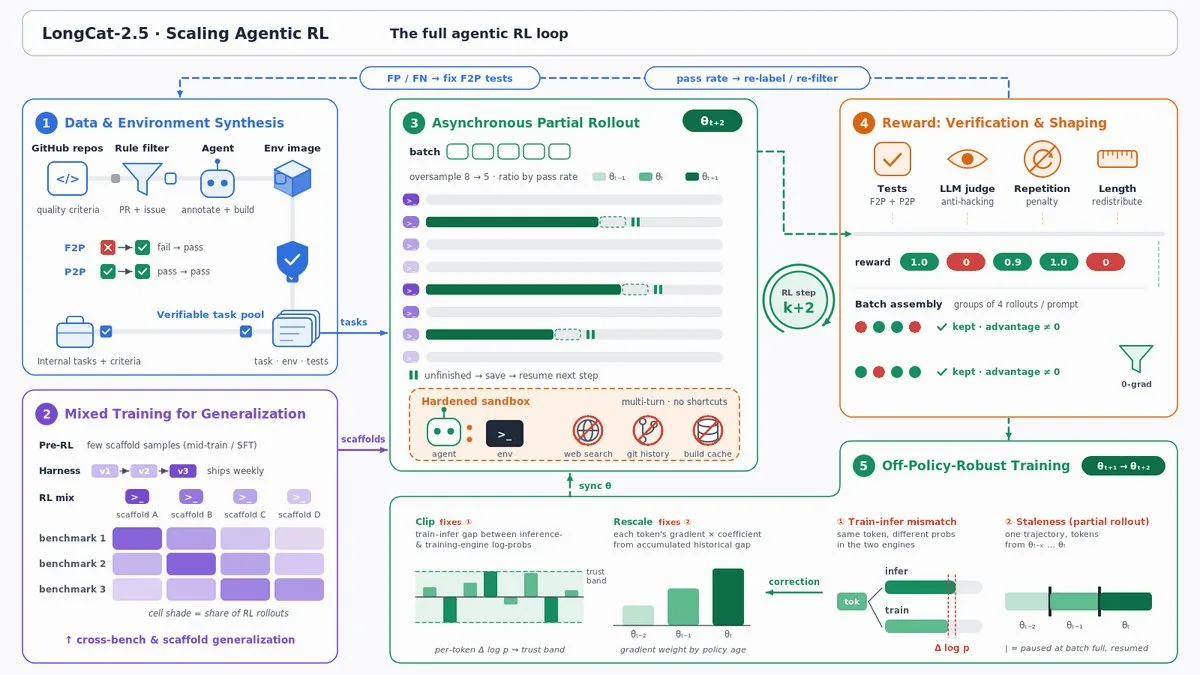
Para el aprendizaje por refuerzo, el equipo empleó tareas reales de programación extraídas de pull requests de GitHub y fallos recreados de agentes. Con el fin de evitar atajos durante el entrenamiento, los desarrolladores bloquearon el acceso a internet en los entornos sandbox, eliminaron el historial de Git y los archivos en caché, y utilizaron un modelo de lenguaje como juez para verificar las soluciones, además de destilar capacidades de varios modelos docentes especializados en trabajo agéntico, razonamiento y diálogo.
Cuantización de 4 bits y despliegue en chips Huawei Ascend
Meituan cuantiza los pesos y activaciones de los expertos a precisión de 4 bits, un formato que los aceleradores chinos procesan de forma nativa. En sus pruebas de carga frente a una versión de 8 bits, el throughput aumenta un 43,3 % en el procesamiento de prompts y un 42,77 % en la generación de respuestas, manteniendo una precisión equiparable a la del modelo sin comprimir.
Esta variante cuantizada está disponible en un repositorio independiente en Hugging Face. Además, la guía de autoalojamiento detalla un despliegue sobre un clúster de 194 aceleradores Huawei Ascend de la serie Atlas A2 —dos dedicados al procesamiento de imágenes, 64 a la ingesta de prompts y 128 a la generación de respuestas—, sin documentación para GPU de Nvidia.
Rendimiento en benchmarks frente a modelos occidentales y chinos
En las evaluaciones publicadas por Meituan, LongCat-2.5 muestra un salto notable respecto a LongCat-2.0 y compite de cerca con modelos occidentales de referencia en tareas de terminal, corrección de errores en repositorios reales y búsqueda web, aunque las versiones más recientes Claude Opus 5.5 y GPT-6.1 Sol no figuran en la comparativa.
| Benchmark | LongCat-2.5 | LongCat-2.0 | Claude Opus 5 | Claude Opus 4.8 | GPT-5.6 Sol | Deepseek-V4.1-Flash |
|---|---|---|---|---|---|---|
| Terminal Bench v2.1 | 88,4 | — | 89,1 | — | 88,8 | 90,6 |
| DeepSWE | 64,6 | 9,7 | — | Inferior a 64,6 | 72,7 | 74,2 |
| Terminal Bench v4.0 | 38,5 | — | 53,9 | — | 37,3 | — |
| BrowseComp (entorno propio) | 91,9 | — | — | — | — | — |
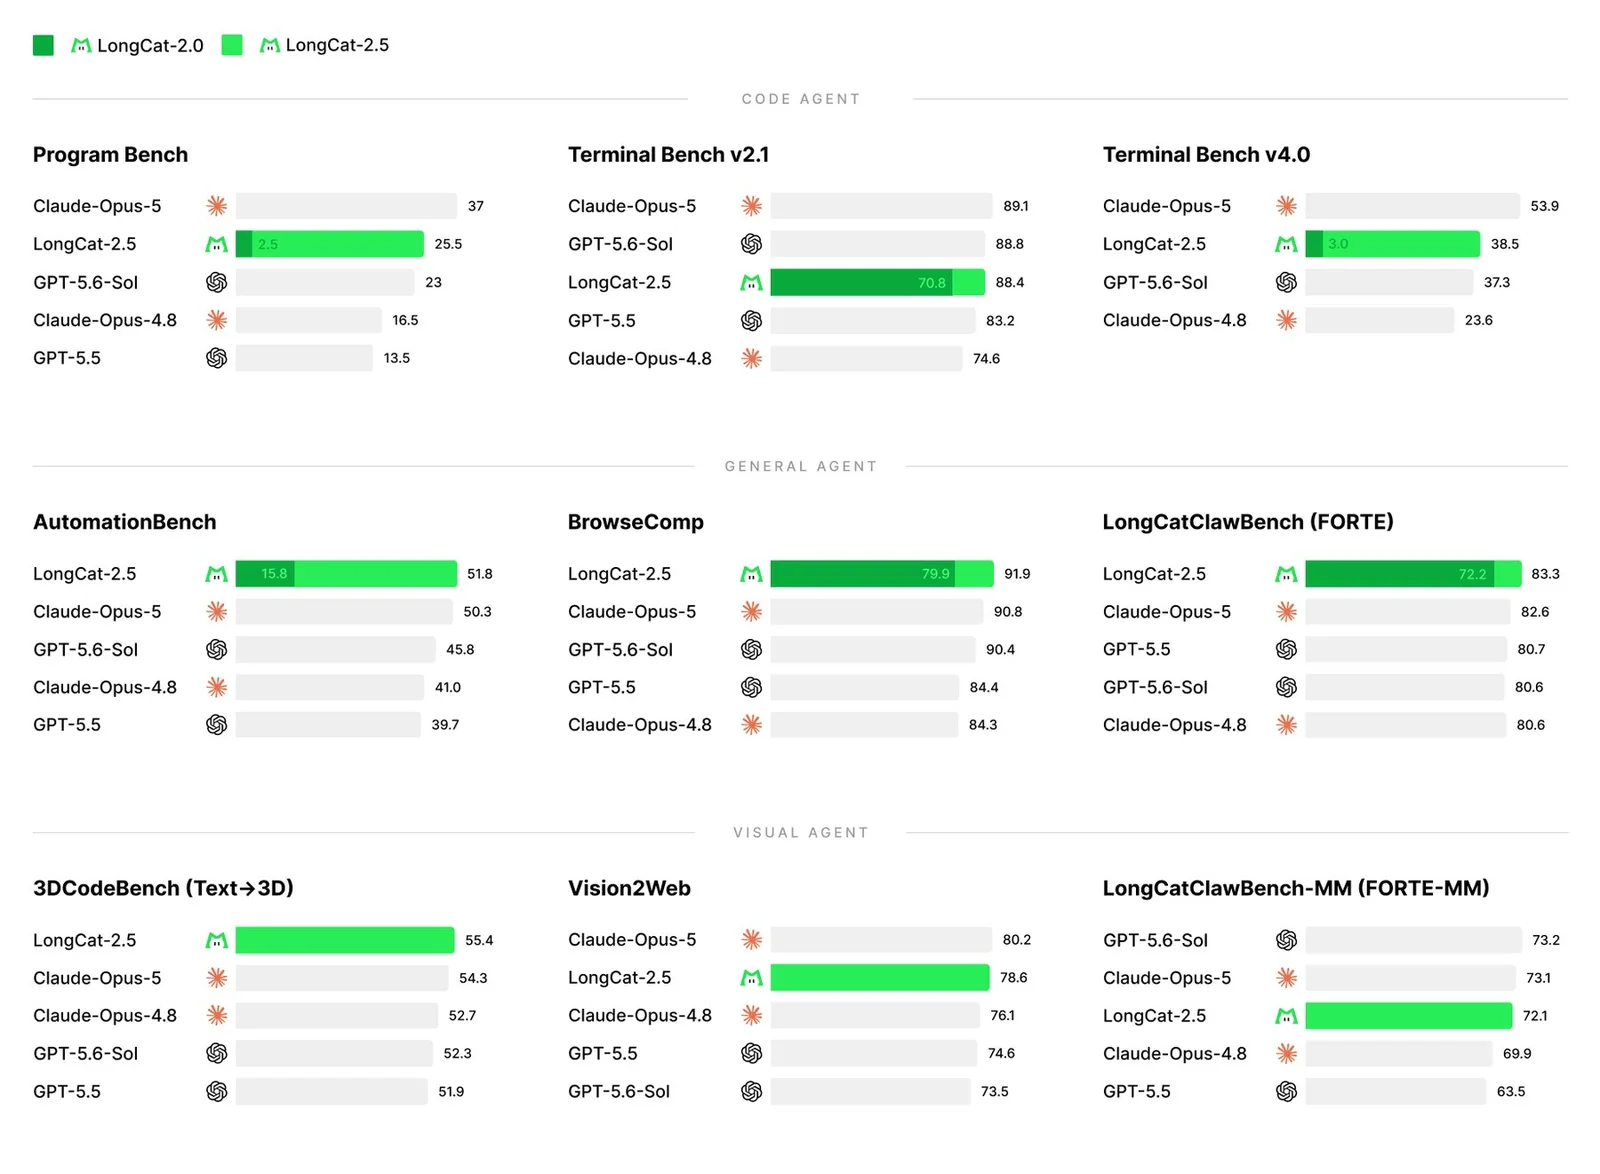
En BrowseComp, el modelo logra la puntuación más alta de la tabla, aunque Meituan ejecutó esa prueba dentro de su propio entorno.
Licencia MIT, precios de lanzamiento y ecosistema sin Nvidia
Los pesos principales se distribuyen en Hugging Face bajo licencia MIT, lo que habilita su uso comercial, modificación y redistribución, y también pueden probarse mediante una interfaz de chat en longcat.ai. Su API es compatible con los formatos de OpenAI y Anthropic para integrarse en harnesses como Claude Code, Codex y Hermes, con una tarifa promocional de lanzamiento equivalente a unos 0,27 euros por millón de tokens de entrada y 1,07 euros por millón de tokens de salida.
Meituan ya había entrenado LongCat-2.0 a finales de junio en un clúster superior a 50.000 chips chinos de IA, tras haber operado de forma anónima como «Owl Alpha» en OpenRouter. Junto a propuestas open-weight como Kimi K3.1 y GLM-5.3, estos desarrollos optimizados de origen para silicio chino amplían el atractivo de ese hardware fuera de China y se suman a lanzamientos previos de la compañía como LongCat-Image, un modelo open source de texto a imagen de 6.000 millones de parámetros.
Fuente: The Decoder